Cloud-Backend und Auswertungen für Gerätedaten
Vom Gerät zur Auswertung: welche Stufe welches Problem abfängt, warum Kardinalität Ablagen überfordert, was in der Cloud tatsächlich Geld kostet, wie Auswertungen aussehen, die benutzt werden, und wann sich ein eigener Aufbau lohnt.
Kurz gefasst
- Jede Stufe fängt genau ein Problem ab. Wer eine auslässt, verliert Daten beim ersten Ausfall.
- Der Zeitstempel gehört zum Messwert, nicht zum Zeitpunkt des Eintreffens.
- Kardinalität bringt Ablagen zu Fall, nicht die Datenmenge.
- Abfragen kosten mehr als Speicherung. Verdichtung ist der größte Kostenhebel.
- Mandantentrennung gehört an die Datenabfrage, nicht in die Oberfläche.
Was das Backend tatsächlich leisten muss
Zwischen einem Gerät, das Messwerte sendet, und einer Auswertung, die jemand benutzt, liegt eine Kette von Aufgaben, die in Angeboten meist als ein einziger Posten erscheint. Sie besteht tatsächlich aus sechs Teilen, und jeder hat genau ein Problem, für das er existiert.
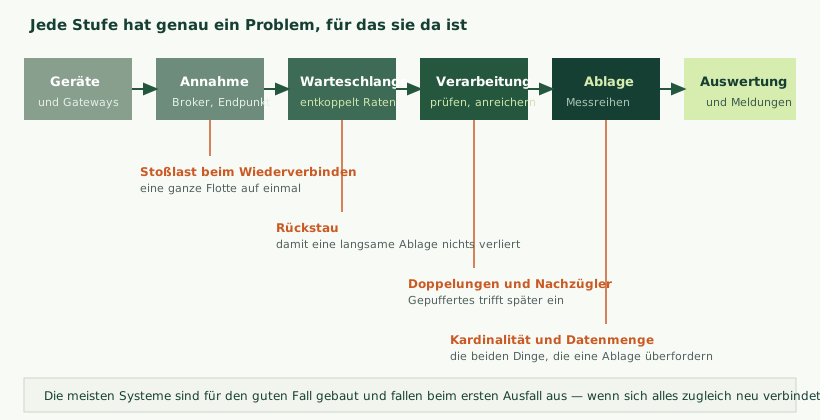
Der Satz unter der Darstellung beschreibt das wiederkehrende Muster. Ein System, das im Versuch mit fünf Geräten einwandfrei arbeitet, verhält sich mit fünfhundert Geräten nach einer Netzstörung völlig anders — nicht weil es hundertmal so viel Last hat, sondern weil sich alle gleichzeitig wieder verbinden und ihre gepufferten Werte auf einmal abladen.
Annahme, und die Stoßlast, mit der niemand rechnet
Die Annahmestelle ist der Punkt, an dem Geräte ihre Werte abliefern — ein Broker, ein Endpunkt, ein verwalteter Dienst. Ihre Aufgabe ist nicht, die durchschnittliche Last zu tragen, sondern die Spitze.
Die Rechnung dazu wird selten aufgemacht und ist einfach: Fünfhundert Geräte, die alle fünf Minuten einen Wert senden, erzeugen im Mittel weniger als zwei Meldungen je Sekunde. Nach einem einstündigen Netzausfall haben dieselben Geräte je zwölf Werte gepuffert, und sie liefern sie innerhalb weniger Sekunden — sechstausend Meldungen in einem Moment, in dem die Verbindung gerade erst wieder steht.
Vier Vorkehrungen fangen das ab:
- Zufälliger Versatz beim Wiederverbinden. Im Gerät umgesetzt, wenige Zeilen, und die wirksamste Maßnahme überhaupt.
- Zunehmende Wartezeiten zwischen den Versuchen, statt fester Abstände.
- Eine Warteschlange unmittelbar hinter der Annahme, die Annahme und Verarbeitung entkoppelt.
- Eine Begrenzung je Gerät, damit ein einzelnes fehlerhaftes Gerät nicht das ganze System beschäftigt.
Der letzte Punkt ist derjenige, der in der Praxis am häufigsten gebraucht wird und am seltensten vorgesehen ist. Ein Gerät mit fehlerhafter Software, das statt alle fünf Minuten jede Sekunde sendet, erzeugt mehr Last als die übrigen vierhundertneunundneunzig zusammen — und ohne Begrenzung merkt man es an der Rechnung.
Verarbeitung: prüfen, entdoppeln, anreichern
Zwischen Annahme und Ablage gehört eine Stufe, die aus einer eingegangenen Nachricht einen brauchbaren Messwert macht. Sie ist der Ort, an dem die Datenqualität entsteht — oder eben nicht.
- Prüfen. Liegt der Wert im physikalisch möglichen Bereich? Ist der Zeitstempel plausibel? Ein Gerät mit falsch gestellter Uhr liefert Werte, die in der Zukunft liegen, und die verderben jede Auswertung still.
- Entdoppeln. Nach einer Unterbrechung sendet ein Gerät gelegentlich Werte erneut, die bereits angekommen waren. Eine Kennung aus Gerät, Messgröße und Zeitpunkt macht sie erkennbar.
- Anreichern. Der Messwert allein sagt wenig; erst mit Standort, Anlage, Einheit und gegebenenfalls laufendem Auftrag wird er auswertbar. Diese Angaben kommen nicht aus dem Gerät, sondern aus einem Stammdatenbestand.
- Umrechnen. Rohwerte in physikalische Größen, mit Skalierung und Offset — und der Rohwert bleibt zumindest eine Zeit lang erhalten, weil ein erheblicher Teil scheinbarer Messfehler Umrechnungsfehler sind.
- Kennzeichnen. Ein als unglaubwürdig erkannter Wert wird als solcher weitergereicht, nicht verworfen und nicht ersetzt.
Zum Zeitstempel eine Festlegung, die alles Weitere bestimmt: Er gehört zum Messwert und nicht zum Zeitpunkt des Eintreffens. Wo das nicht beachtet wird, landen alle nachgelieferten Werte einer Unterbrechung in derselben Sekunde — und die Aufzeichnung sieht aus, als wäre eine Stunde lang nichts passiert und danach alles auf einmal. Das ist schlimmer als eine sichtbare Lücke, weil es unauffällig falsch ist.
Ablage: warum gewöhnliche Datenbanken an Grenzen stoßen
Gerätedaten haben eine Eigenart, die sie von gewöhnlichen Anwendungsdaten unterscheidet: Sie werden fortlaufend geschrieben, fast nie geändert, und ihre Abfragen lauten fast immer „diese Messgröße über diesen Zeitraum“. Genau darauf sind Messreihendatenbanken zugeschnitten.
Das heißt nicht, dass eine gewöhnliche Datenbank ungeeignet wäre. Für viele Vorhaben ist sie die richtige Wahl, und es lohnt sich, die Grenze zu kennen statt sie zu vermuten: Bei zehn Geräten mit einem Wert je Minute dauert es Jahre, bis überhaupt zehn Millionen Datensätze zusammenkommen — eine Menge, die jede vernünftige Datenbank verkraftet.
Was tatsächlich zu Schwierigkeiten führt, sind zwei Dinge, und nur eines davon ist die Datenmenge.
Kardinalität, die Größe, die überrascht
Kardinalität ist die Zahl der unterschiedlichen Merkmalskombinationen, unter denen Werte abgelegt werden. Zehn Geräte mal fünf Messgrößen ergeben fünfzig Reihen — unproblematisch. Zehn Geräte mal fünf Messgrößen mal drei Standorte ergeben hundertfünfzig — ebenfalls unproblematisch.
Zum Problem wird es, sobald ein Merkmal aufgenommen wird, das viele verschiedene Werte annimmt: eine Chargennummer, eine Auftragsnummer, eine Seriennummer des gemessenen Teils. Aus hundertfünfzig Reihen werden dann über die Zeit Millionen, weil jede neue Charge eine neue Kombination erzeugt. Messreihendatenbanken halten je Reihe Verwaltungsdaten im Arbeitsspeicher, und ab einer gewissen Zahl werden sie langsam — schleichend, über Wochen, ohne dass sich die Datenmenge erkennbar verändert hätte.
Die Regel, die daraus folgt, lässt sich in einem Satz sagen: Merkmale sind für Dinge, die sich selten ändern; alles, was viele Werte annimmt, gehört in den Datensatz und nicht in die Merkmale. Eine Chargennummer gehört als Feld zum Messwert, nicht als Merkmal der Reihe.
Aufbewahrung und Verdichtung
Die zweite Größe ist die Menge, und sie lässt sich beherrschen — wenn man es früh entscheidet.
| Auflösung | Dauer | Wofür |
|---|---|---|
| Volle Auflösung | zwei bis acht Wochen | Fehlersuche, Betrachtung eines Ereignisses im Detail |
| Minutenwerte | ein Jahr | Vergleich von Schichten, Tagen, Chargen |
| Stundenwerte | fünf Jahre und mehr | Jahresvergleiche, Verbrauchsentwicklung, Nachweise |
| Ereignisse und Alarme | so lange wie die Messwerte | Sie sind klein und erklären die Verläufe |
Beim Verdichten lohnt es sich, mehr als den Mittelwert zu behalten: Minimum, Maximum und die Zahl der eingegangenen Werte. Ein Stundenmittel allein verdeckt genau die Spitzen, wegen derer jemand später hinsieht — und die Zahl der Werte zeigt, ob in dieser Stunde überhaupt vollständig gemessen wurde.
Diese Regel früh festzulegen ist wichtiger, als sie perfekt zu treffen. Verdichten lässt sich nur, was noch vorhanden ist; wer erst nach drei Jahren darüber nachdenkt, hat die Wahl bereits verloren. Wie sich das im industriellen Umfeld einordnet, behandeln wir unter Maschinendaten erfassen und auswerten.
Selbst bauen oder kaufen
Die Frage stellt sich in jedem solchen Vorhaben, und sie wird meist zu früh entschieden. Es lohnt sich, sie in ihre Bestandteile zu zerlegen, weil die Antwort für die einzelnen Stufen unterschiedlich ausfallen kann.
Eine fertige Plattform liefert innerhalb von Tagen eine Annahmestelle, eine Ablage, eine Oberfläche und eine Geräteverwaltung. Das ist ein erheblicher Vorsprung, und für viele Vorhaben ist sie die richtige Wahl — insbesondere, solange die Anforderungen gewöhnlich sind und niemand im Haus Server betreuen möchte. Die Nachteile zeigen sich mit der Zeit: Die Preismodelle wachsen mit der Zahl der Geräte, der Messgrößen oder der Nachrichten; die Anpassbarkeit endet dort, wo der Anbieter sie enden lässt; und die eigenen Daten liegen in einem System, dessen Export selten so gut ist wie sein Import.
Ein eigener Aufbau aus offenen Bausteinen kostet mehr Zeit am Anfang und weniger im Betrieb. Er lohnt sich, wenn die Anforderungen ungewöhnlich sind, wenn die Datenmenge groß wird, wenn das System Teil eines Produkts ist, das Sie verkaufen, oder wenn die Bindung an einen Anbieter aus geschäftlichen Gründen nicht in Frage kommt. Er setzt allerdings voraus, dass jemand ihn dauerhaft betreut — und das ist eine Personalfrage, keine technische.
Die Mischform ist in der Praxis am häufigsten und selten geplant: eine fertige Annahmestelle, eine eigene Verarbeitung, eine zugekaufte Ablage, eine eigene Oberfläche. Das ist kein Kompromiss aus Unentschlossenheit, sondern die Anerkennung, dass die Stufen verschiedene Anforderungen haben.
Unser Rat ist, die Entscheidung so lange offenzuhalten, wie sie offenbleiben kann — und dafür an einer Stelle Sorgfalt zu investieren: Die Schnittstelle zur Ablage gehört gekapselt. Wenn der Rest des Systems nicht unmittelbar mit der Datenbank spricht, sondern über eine eigene Zwischenschicht, lässt sich die Ablage später austauschen, ohne alles andere anzufassen. Das kostet beim ersten Aufbau wenige Stunden und erspart später Wochen.
Klein anfangen, ohne sich einzumauern
Ein häufiger Fehler ist, das System für die erwartete Größe in fünf Jahren zu bauen. Der entgegengesetzte Fehler ist, so zu bauen, dass eine Vergrößerung einen Neuanfang bedeutet. Zwischen beidem liegt ein schmaler, gut begehbarer Weg.
Was sich bedenkenlos einfach halten lässt:
- Eine gewöhnliche Datenbank statt einer Messreihendatenbank, solange die Menge es zulässt.
- Ein einzelner Rechner statt einer verteilten Anordnung.
- Eine fertige Auswertungsoberfläche statt einer eigenen Entwicklung.
- Regelmäßig laufende Verarbeitungsschritte statt einer fortlaufenden Verarbeitung.
Was von Anfang an richtig sein sollte:
- Die Benennung der Messstellen, weil sie sich nachträglich nur mit Umbenennung historischer Daten korrigieren lässt.
- Der Zeitstempel am Messwert statt am Eintreffen, weil sich das später nicht rekonstruieren lässt.
- Die Mandantentrennung, wenn mehrere Kunden beteiligt sein werden.
- Die Kapselung der Ablage, damit ein Wechsel möglich bleibt.
- Die Aufbewahrungs- und Verdichtungsregel, weil verdichten nur kann, wer noch Daten hat.
Die Unterscheidung folgt einem einfachen Prinzip: Alles, was sich später mit Arbeit nachholen lässt, darf am Anfang einfach sein. Alles, was Information vernichtet, wenn es fehlt, muss von Anfang an stimmen.
Was die Kosten tatsächlich treibt
Die Rechnung eines Cloud-Anbieters folgt selten der Vorstellung, die man vorher davon hatte. Die üblichen Überraschungen lassen sich benennen.
| Posten | Einschätzung |
|---|---|
| Speicherung roher Messwerte | Erstaunlich billig; selten der Grund für eine hohe Rechnung |
| Abfragen über lange Zeiträume | Häufig der größte Posten, besonders bei sich selbst aktualisierenden Auswertungen |
| Ausgehender Datenverkehr | Wird regelmäßig übersehen; bei Bildern und Exporten erheblich |
| Dauerhaft laufende Dienste | Kosten auch dann, wenn nichts zu tun ist |
| Verwaltete Dienste mit Bereitstellungspreis | Bequem und je Stunde bepreist, unabhängig von der Nutzung |
| Nachrichten je Gerät | Bei Plattformen der Posten, der mit der Flotte wächst |
| Sicherungen und Ausfallsicherheit | Notwendig und in Schätzungen regelmäßig vergessen |
Die zweite Zeile verdient ein Beispiel, weil sie so häufig unterschätzt wird. Eine Auswertung, die sich alle dreißig Sekunden selbst aktualisiert und dabei ein Jahr an Messwerten durchsucht, führt diese Abfrage gut hunderttausend Mal im Monat aus — und wenn zehn Personen sie geöffnet haben, zehnmal so oft. Dieselbe Auswertung auf verdichtete Stundenwerte umgestellt und auf ein Aktualisierungsintervall von fünf Minuten gesetzt, kostet einen Bruchteil und zeigt dasselbe.
Daraus ergeben sich drei Maßnahmen, die zusammen die Rechnung regelmäßig halbieren: auf verdichtete Daten abfragen statt auf rohe, Aktualisierungsintervalle an die tatsächliche Änderungsrate anpassen, und häufig gestellte Abfragen im Voraus berechnen statt bei jedem Aufruf.
Auswertungen, die benutzt werden
Die technisch fertige Datenstrecke erzeugt noch keinen Nutzen. Er entsteht erst, wenn jemand etwas anders macht — und ob das geschieht, entscheidet sich an der Darstellung.
Die wiederkehrende Beobachtung: Auswertungen mit vielen Anzeigen und Verläufen werden zur Eröffnung bewundert und nach drei Wochen nicht mehr geöffnet. Was benutzt wird, sieht anders aus.
- Sie beantwortet eine Frage, und zwar eine, die jemand tatsächlich hat — nicht „wie läuft es?“, sondern „welche Anlage steht heute schlechter da als gestern?“.
- Sie zeigt die Ausnahmen zuerst. Was in Ordnung ist, braucht keine Fläche. Was auffällig ist, gehört nach oben.
- Sie enthält einen Vergleich. Eine Zahl allein sagt nichts; im Vergleich zur Vorwoche, zum Sollwert oder zur Nachbaranlage sagt sie etwas.
- Sie ist für ein Gerät gebaut, auf dem sie tatsächlich angesehen wird — häufig ein Telefon oder ein Bildschirm in der Halle, nicht ein großer Monitor.
- Sie lädt schnell. Eine Ansicht, die zehn Sekunden braucht, wird nicht beiläufig geöffnet.
- Sie hat einen Eigentümer, der sie ändern darf und kann.
Der letzte Punkt entscheidet über die Haltbarkeit. Eine Auswertung, für deren Änderung ein Angebot eingeholt werden muss, wird nicht geändert — und eine Auswertung, die sich nicht ändert, passt nach einem Jahr nicht mehr zu den Fragen, die inzwischen gestellt werden.
Ein praktischer Hinweis zur Einführung: Die brauchbarste Vorgehensweise ist, eine erste Fassung zusammen mit demjenigen zu bauen, der sie benutzen soll, und sie nach zwei Wochen gemeinsam durchzugehen. Was dabei herauskommt, sieht regelmäßig anders aus als das, was am Anfang bestellt wurde — und wird benutzt.
Meldungen, und warum sie schwieriger sind, als sie aussehen
Eine Grenzwertprüfung mit einer Nachricht ist in einer Stunde gebaut. Was Zeit kostet und über die Brauchbarkeit entscheidet, ist alles darum herum.
- Verzögerung. Eine Grenze ohne Verzögerung meldet jede kurze Schwankung. Eine Bedingung wie „länger als fünf Minuten überschritten“ beseitigt den größten Teil der Fehlmeldungen.
- Hysterese. Ohne sie meldet ein Wert, der um die Schwelle pendelt, im Minutentakt — abwechselnd Alarm und Entwarnung.
- Zusammenfassung. Wenn eine Störung zwanzig Messstellen zugleich betrifft, sollte eine Meldung entstehen und nicht zwanzig.
- Eskalation. Was geschieht, wenn der Erstempfänger nicht reagiert? Ohne zweite Stufe ist eine Meldung nachts wirkungslos.
- Quittierung. Ohne sie ist nicht feststellbar, ob jemand die Meldung zur Kenntnis genommen hat.
- Ruhezeiten. Eine Meldung um drei Uhr nachts, auf die ohnehin erst morgens reagiert wird, erzeugt nur Ärger.
- Die Überwachung der Überwachung. Ein System, das nichts meldet, weil es selbst ausgefallen ist, sieht von außen aus wie Ruhe.
Der letzte Punkt ist der wichtigste und der am häufigsten fehlende. Ein Lebenszeichen in festem Abstand und eine Meldung, wenn es ausbleibt, kosten wenig und sind die Voraussetzung dafür, dass man einer Überwachung überhaupt trauen kann.
Eine Beobachtung aus mehreren Projekten: Die häufigste Ursache für Meldungsmüdigkeit ist nicht eine zu enge Grenze, sondern eine Messstelle, die etwas anderes misst, als angenommen wurde. Bevor an der Schwelle gedreht wird, lohnt sich die Frage, ob die Messung die richtige Größe erfasst.
Schnittstellen und der Weg aus dem System heraus
Ein System, aus dem sich Daten nur über die eigene Oberfläche ansehen lassen, wird zur Sackgasse. Von Anfang an gehört ein Weg dazu, die Daten auch anderweitig zu verwenden.
- Eine Abfrageschnittstelle, über die sich Messreihen für einen Zeitraum abrufen lassen — mit Begrenzung der Menge je Anfrage und einer Möglichkeit, große Zeiträume seitenweise zu holen.
- Ein Export in ein offenes Format, weil es immer jemanden gibt, der die Daten in einer Tabellenkalkulation ansehen möchte, und weil das der einfachste Weg ist, Vertrauen aufzubauen.
- Eine Benachrichtigung bei Ereignissen, damit andere Systeme reagieren können, ohne fortlaufend nachzufragen.
- Zugangsverwaltung mit begrenzten Rechten, damit ein auswertendes System nur lesen darf.
- Eine Beschreibung der Schnittstelle, die aktuell ist — sonst wird sie nicht benutzt, sondern umgangen.
Der zweite Punkt wird häufig belächelt und ist in der Praxis der meistgenutzte. Die Fähigkeit, einen Zeitraum als Tabelle herunterzuladen, beantwortet einen erheblichen Teil der Sonderfragen, für die sonst eine eigene Auswertung gebaut werden müsste.
Ereignisse sind wertvoller als Messwerte
Eine Beobachtung, die sich in mehreren Systemen bestätigt hat: Der Datenbestand, aus dem später der meiste Nutzen gezogen wird, besteht nicht aus Messreihen, sondern aus Ereignissen — ein Start, ein Stillstand, eine Grenzwertüberschreitung, ein Werkzeugwechsel, eine Störmeldung, ein Wartungseinsatz.
Ereignisse sind klein, sie fallen selten an, und sie sind der Grund dafür, dass die Messreihen so aussehen, wie sie aussehen. Eine Kurve, die an drei Stellen abfällt, ist ohne Ereignisse ein Rätsel und mit ihnen eine Erklärung.
Daraus folgen drei Empfehlungen, die wenig kosten. Erstens gehören Ereignisse mit derselben Sorgfalt erfasst wie Messwerte, mit Zeitpunkt, Quelle, Art und — wo vorhanden — Grund. Zweitens sollten sie deutlich länger aufbewahrt werden als die rohen Messreihen, weil sie wenig Platz brauchen und viel erklären. Drittens gehören sie in jede Darstellung eines Verlaufs hinein, als Markierung auf der Zeitachse: Wer eine Kurve ansieht und die zugehörigen Ereignisse daneben hat, stellt die richtige Frage in Sekunden statt in Stunden.
Berichte sind keine Auswertungen
Ein Unterschied, der regelmäßig übersehen wird: Eine Auswertung wird angesehen, wenn jemand etwas wissen will. Ein Bericht kommt von selbst, auch wenn niemand daran gedacht hat.
Beide werden gebraucht, und sie unterscheiden sich in fast allem. Ein Bericht hat einen festen Zeitraum, einen festen Empfängerkreis, eine feste Form und wird archiviert. Eine Auswertung ist beweglich, zeigt den aktuellen Stand und wird nicht aufbewahrt.
In der Praxis ist der wöchentliche oder monatliche Bericht häufig das Mittel, das die Veränderung bewirkt — weil er auch diejenigen erreicht, die keine Auswertung öffnen. Drei Eigenschaften machen ihn brauchbar: Er passt auf eine Seite, er enthält einen Vergleich zum vorigen Zeitraum, und er nennt die zwei oder drei Punkte, die Aufmerksamkeit verdienen. Ein Bericht mit dreißig Zahlen wird abgeheftet.
Geräteverwaltung, die Hälfte des Systems
Ein Teil, der in Entwürfen regelmäßig fehlt und im Betrieb die Hälfte der Arbeit ausmacht: Woher weiß das System, welche Geräte es gibt, und wie werden sie betreut?
- Anmeldung. Wie kommt ein neues Gerät ins System — von Hand, über einen Code auf dem Gehäuse, automatisch beim ersten Verbinden? Bei großen Stückzahlen ist das ein Vorgang in der Fertigung und keine Nebensache.
- Stammdaten. Welches Gerät sitzt an welcher Anlage, seit wann, mit welchem Firmwarestand und welcher Konfiguration.
- Zustandsüberwachung der Geräte selbst. Batteriespannung, Signalstärke, Zeitpunkt der letzten Meldung. Eine Übersicht der auffälligen Geräte statt einer Liste aller.
- Konfigurationsänderungen. Messrate, Grenzwerte, Sendeverhalten — änderbar über die Luft, mit einer Rückmeldung, dass die Änderung angekommen ist.
- Aktualisierungen der Gerätesoftware, stufenweise ausgerollt und mit einem Weg zurück.
- Abmeldung. Was geschieht mit den Daten eines Geräts, das ausgebaut, verkauft oder verschrottet wird?
Der vorletzte Punkt verdient eigene Sorgfalt, weil ein Fehler dort die ganze Flotte betrifft. Eine fehlerhafte Aktualisierung, die gleichzeitig an alle Geräte geht, ist der teuerste vermeidbare Zwischenfall eines solchen Systems. Wie sich das absichern lässt, behandeln wir gesondert; die Grundregel lautet, stufenweise auszurollen und den Fortschritt an der Rückmeldung der Geräte zu messen statt an der Zahl der versendeten Pakete.
Auf den Verbindungsausfall hin entwerfen
Die Verbindung wird ausfallen — bei Bauarbeiten, Netzumstellungen, Gewitter und Wartungsfenstern. Ein System, das nur den guten Fall beherrscht, verliert dabei Daten, und zwar meist genau die interessanten.
Was auf jeder Seite vorgesehen sein muss:
- Im Gerät: Zwischenspeicher, ursprüngliche Zeitstempel, zunehmende Wartezeiten, zufälliger Versatz beim Wiederverbinden, und eine bewusste Entscheidung, was bei vollem Speicher verworfen wird.
- In der Annahme: Aufnahmefähigkeit für die Stoßlast, Begrenzung je Gerät, und eine Warteschlange, die die Verarbeitung entkoppelt.
- In der Verarbeitung: Erkennung von Doppelungen, Umgang mit Nachzüglern, und die Frage, ob ein verspäteter Wert eine bereits berechnete Verdichtung erneuert.
- In der Auswertung: Lücken als Lücken darstellen, nicht als Nulllinie und nicht durch Verbinden der Punkte überdecken.
Der letzte Punkt ist derjenige, der am häufigsten falsch gemacht wird und den größten Schaden anrichtet. Eine Kurve, die über eine Datenlücke hinweg durchgezogen wird, behauptet etwas, das niemand gemessen hat — und wer sie ansieht, hat keine Möglichkeit, das zu erkennen.
Das Datenmodell entwerfen
Die folgenreichsten Entscheidungen eines solchen Systems werden früh getroffen und sind später teuer zu ändern. Drei davon verdienen Aufmerksamkeit.
Was einen Messwert kennzeichnet
Ein Messwert braucht mindestens: die Quelle, die Messgröße, den Zeitpunkt, den Wert, die Einheit und ein Qualitätskennzeichen. Die ersten drei zusammen bilden die Kennung, mit der sich Doppelungen erkennen lassen.
Der Punkt, der am häufigsten fehlt, ist das Qualitätskennzeichen. Ein Wert kann gültig, geschätzt, außerhalb des Bereichs, veraltet oder unsicher sein — und diese Unterscheidung geht verloren, wenn nur die Zahl gespeichert wird. Sie später nachzurüsten bedeutet, dass alle vorhandenen Werte ohne Kennzeichen dastehen.
Einheiten, und die Verwirrung, die sie stiften
Eine Zahl ohne Einheit ist keine Messung. Trotzdem werden Einheiten regelmäßig als selbstverständlich behandelt — bis ein Gerät in Grad Fahrenheit liefert, ein zweites in Kelvin, und beide in derselben Auswertung landen.
Die brauchbare Festlegung: Einheiten werden bei der Verarbeitung auf eine festgelegte Grundeinheit umgerechnet und in dieser abgelegt, die Umrechnung für die Anzeige geschieht erst in der Oberfläche. Ein Bestand, in dem dieselbe Messgröße in verschiedenen Einheiten liegt, ist nicht auswertbar, ohne dass jede Abfrage die Einheit mitberücksichtigt — und irgendwann vergisst es jemand.
Eine Benennung, die überdauert
Die Bezeichnung einer Messstelle muss einen Gerätetausch, eine Umbenennung der Anlage und einen Personalwechsel überstehen. Drei Regeln haben sich bewährt:
- Nach der Anlage benennen, nicht nach dem Gerät. Das Gerät wird getauscht, die Anlage bleibt.
- Keine veränderlichen Angaben im Namen. Weder die Abteilung noch der Zuständige noch die Netzadresse.
- Eine Struktur, die sich erweitern lässt, ohne bestehende Namen zu ändern — Standort, Bereich, Anlage, Messgröße.
Diese Festlegung kostet einen Nachmittag und entscheidet darüber, ob der Datenbestand in fünf Jahren noch auswertbar ist. Sie nachträglich zu korrigieren bedeutet, historische Daten umzubenennen — was möglich ist und jedes Mal etwas kostet.
Wem die Auswertung gehört, sobald es sie gibt
Eine Frage, die technisch bedeutungslos wirkt und über die Haltbarkeit des Systems mehr entscheidet als jede Entwurfsentscheidung: Wer darf die Auswertungen ändern, und wer tut es tatsächlich?
Der übliche Verlauf ist dieser. Zur Inbetriebnahme baut der Dienstleister eine Ansicht, die genau zu den Fragen passt, die damals gestellt wurden. Nach einigen Monaten ändern sich die Fragen — eine neue Anlage kommt hinzu, eine Kennzahl wird anders definiert, jemand möchte eine Sicht je Schicht statt je Tag. Muss dafür ein Angebot eingeholt werden, unterbleibt die Änderung. Nach einem Jahr passt die Ansicht nicht mehr zu dem, was die Beteiligten wissen wollen, und sie wird nicht mehr geöffnet.
Dagegen hilft weniger Technik als eine bewusste Übergabe:
- Eine benannte Person im Haus, die Auswertungen anlegen und ändern darf — nicht die IT-Abteilung allgemein, sondern jemand mit fachlichem Bezug.
- Eine Einweisung, die über das Ansehen hinausgeht: wie eine Ansicht kopiert, angepasst und veröffentlicht wird.
- Eine Trennung zwischen dem, was verlässlich bleiben muss — die Berichte, auf die sich andere stützen — und dem, was frei veränderbar ist.
- Eine Sicherung der Ansichten, damit eine verunglückte Änderung keine Neuentwicklung nach sich zieht.
Diese Übergabe kostet einen halben Tag und ist erfahrungsgemäß der Unterschied zwischen einem System, das nach zwei Jahren noch benutzt wird, und einem, das technisch einwandfrei läuft und niemanden mehr interessiert.
Mandantentrennung und Sicherheit
Wo ein System Daten mehrerer Kunden hält, ist die Trennung die folgenreichste Entwurfsentscheidung überhaupt — und die einzige, die sich nachträglich kaum nachrüsten lässt.
Die Grundregel lautet: Die Einschränkung gehört an die Stelle, an der die Daten geholt werden, nicht in die Anzeige. Jeder Datensatz trägt eine Zugehörigkeit, und jede Abfrage wird auf die Zugehörigkeit des Anfragenden eingeschränkt, bevor überhaupt Daten gelesen werden. Wer die Einschränkung erst in der Oberfläche vornimmt, hat sie nicht — es genügt dann eine übersehene Ansicht oder ein Aufruf der Schnittstelle mit veränderten Merkmalen.
Ergänzend gehören dazu:
- Geräte weisen sich aus, und zwar mit einem Geheimnis je Gerät, nicht mit einem gemeinsamen für die ganze Flotte. Ein gemeinsames Geheimnis bedeutet, dass ein einziges ausgelesenes Gerät die gesamte Flotte betrifft.
- Übertragung verschlüsselt, in beide Richtungen, mit Prüfung der Gegenstelle auch auf der Geräteseite.
- Rechte nach Rolle statt eines gemeinsamen Zugangs, und ein Nachweis darüber, wer wann was geändert hat.
- Keine Auslieferungszugänge, weder auf Geräten noch auf Diensten.
- Getrennte Umgebungen für Entwicklung und Betrieb, mit getrennten Zugangsdaten — Versuchsgeräte, die in den Bestand des laufenden Betriebs senden, sind eine verbreitete Quelle unerklärlicher Werte.
Für vernetzte Produkte kommen regulatorische Anforderungen hinzu, die inzwischen verbindlich sind und nicht mehr als Kür behandelt werden können. Das betrifft insbesondere die Frage, wie lange Sicherheitsaktualisierungen bereitgestellt werden und wie Schwachstellen gemeldet werden können.
Den Betrieb aufnehmen und aufrechterhalten
Ein solches System ist keine Lieferung, sondern ein Betrieb. Was dafür eingerichtet sein sollte, bevor die ersten Geräte im Feld sind:
- Überwachung des Systems selbst, nicht nur der Daten: Eingangsrate, Länge der Warteschlange, Fehlerquote, Antwortzeiten der Abfragen.
- Meldungen bei Abweichungen, insbesondere bei einem Einbruch der Eingangsrate — das ist der zuverlässigste Hinweis darauf, dass irgendwo etwas ausgefallen ist.
- Sicherungen und ein geprüfter Weg zurück. Eine Sicherung, aus der noch nie wiederhergestellt wurde, ist eine Vermutung.
- Ein Weg, Änderungen einzuspielen, ohne den Datenfluss zu unterbrechen.
- Eine Bereitschaft, sofern das System etwas trägt, das nachts nicht ausfallen darf — und eine ausdrückliche Feststellung, wenn das nicht der Fall ist.
Was in unserer Erfahrung zuerst bricht
Die Reihenfolge ist bemerkenswert beständig:
- Der Speicherplatz. Bei fehlender Aufbewahrungsregel läuft die Ablage voll — meist am Wochenende.
- Die Abfragen. Eine Auswertung wird langsam, weil die Datenmenge gewachsen ist und niemand auf verdichtete Werte umgestellt hat.
- Die Uhren. Ein Gerät mit falsch gestellter Uhr liefert Werte in der Zukunft und verdirbt Auswertungen, ohne dass die Ursache naheliegt.
- Ein einzelnes Gerät. Eine fehlerhafte Gerätesoftware sendet dauerhaft und erzeugt mehr Last als die gesamte übrige Flotte.
- Ein abgelaufenes Zertifikat. Der klassische geplante Ausfall, den niemand geplant hat — und der zwei Jahre nach der Inbetriebnahme eintritt.
Jeder dieser fünf Punkte lässt sich mit einer Überwachung und wenigen Zeilen abfangen. Sie stehen hier, weil sie in der genannten Reihenfolge tatsächlich eintreten und weil sich mit dieser Liste die ersten fünf Überwachungsregeln eines neuen Systems begründen lassen.
Ein durchgerechnetes Beispiel
Zur Veranschaulichung ein Vorhaben mittlerer Größe: ein Maschinenhersteller mit dreihundert Anlagen bei Kunden, je Anlage etwa vierzig Messgrößen im Minutentakt, mit dem Ziel, Störungen früh zu erkennen und Wartungseinsätze vorzubereiten.
Die Mengenrechnung: dreihundert mal vierzig ergibt zwölftausend Messreihen — für eine Messreihendatenbank unproblematisch. Im Minutentakt entstehen daraus rund siebzehn Millionen Werte je Tag, etwa sechs Milliarden im Jahr. In voller Auflösung ein Jahr aufzubewahren wäre möglich und unnötig; nach der oben beschriebenen Regel bleiben acht Wochen voll, danach Minutenwerte für ein Jahr und Stundenwerte für fünf.
Die Kardinalität blieb bei zwölftausend, weil die Auftragsnummer als Feld und nicht als Merkmal abgelegt wurde — hätte man sie als Merkmal geführt, wären daraus binnen eines Jahres mehrere Millionen Reihen geworden.
Der Aufwand lag nicht dort, wo er erwartet worden war. Die Datenstrecke selbst war in wenigen Wochen aufgebaut. Zeit gekostet haben drei andere Dinge: die Einigung darauf, wie die Messstellen über alle Maschinenvarianten hinweg heißen; die Mandantentrennung, weil die Kunden ihre eigenen Anlagen sehen sollten und keine fremden; und die Feststellung, dass ein Teil der Anlagen Uhren hatte, die um bis zu vierzig Minuten falsch gingen — was erst auffiel, als Ereignisse zweier Anlagen miteinander verglichen werden sollten.
Edge, Cloud oder beides
Die Frage, wo verarbeitet wird, hat eine Antwort, die sich in den meisten Fällen wiederholt: beides, mit einer klaren Arbeitsteilung.
Nahe der Anlage gehört hin: alles, was schnell reagieren muss; die Pufferung bei Verbindungsausfall; die Verdichtung, wo ohnehin nicht jeder Rohwert nach außen muss; und alles, was auch bei unterbrochener Verbindung weiterlaufen soll.
Außerhalb gehört hin: die Langzeitablage; die Auswertung über mehrere Standorte hinweg; alles, was von verschiedenen Orten erreichbar sein muss; und rechenintensive Auswertungen, die nur gelegentlich laufen.
Der übliche Fehler ist, alles rohe Material nach außen zu schicken und dort zu entscheiden, was interessant war. Das kostet Bandbreite, Speicher und Abfragen — und in vielen Fällen ließe sich ein erheblicher Teil bereits nahe der Anlage aussortieren, ohne dass Information verloren geht. Die Auslegung dieser Zwischenstufe behandeln wir unter Industrielle Edge-Gateways.
Die Angebote der großen Anbieter
Die großen Cloud-Anbieter haben jeweils eigene Dienste für Gerätedaten im Angebot, und sie verdienen eine nüchterne Einordnung.
Was sie gut können: die Annahme großer Mengen, die Verwaltung von Geräten samt Zertifikaten, Aktualisierungen über die Luft und die Anbindung an die übrigen Dienste desselben Anbieters. Wer dort ohnehin ist, kommt damit schnell voran.
Worauf zu achten ist: Die Preismodelle sind kleinteilig und schwer im Voraus zu überblicken; die Bindung an den Anbieter entsteht weniger durch die Annahmestelle als durch die umliegenden Dienste; und die gelieferte Oberfläche ist selten die, die Ihre Anwender brauchen.
Eine Vorgehensweise, die sich bewährt hat: die Annahmestelle des Anbieters nutzen, weil sie gut ist, und unmittelbar dahinter in ein eigenes, offenes Format übergehen. Damit bleibt der Wechsel möglich, ohne die Geräte im Feld anzufassen — und genau das ist der Punkt, an dem eine Bindung sonst teuer wird.
Die Kosten abschätzen, bevor gebaut wird
Eine Abschätzung vor dem Bau ist möglich und lohnt sich. Die Rechnung braucht fünf Angaben:
- Zahl der Geräte, heute und in drei Jahren.
- Zahl der Messgrößen je Gerät.
- Meldeabstand, getrennt nach Messgrößen, wenn sie sich unterscheiden.
- Aufbewahrung je Auflösung, nach der oben beschriebenen Regel.
- Zahl der Personen, die Auswertungen öffnen, und wie oft sich diese aktualisieren.
Daraus ergibt sich die Zahl der Werte je Tag, die Zahl der Reihen, der Speicherbedarf und die Zahl der Abfragen. Diese Rechnung passt auf eine Seite, dauert eine halbe Stunde und beantwortet die Frage, ob eine gewöhnliche Datenbank genügt — was häufiger der Fall ist, als Anbieter nahelegen.
Wichtiger als die absolute Zahl ist, dass die Rechnung mit der erwarteten Vergrößerung wiederholt wird. Ein System, das bei fünfzig Geräten günstig ist und bei fünfhundert unbezahlbar wird, ist ein Entwurfsfehler und kein Preisproblem.
Kleines Glossar
| Begriff | Was gemeint ist |
|---|---|
| Annahmestelle | Der Punkt, an dem Geräte ihre Werte abliefern |
| Warteschlange | Zwischenspeicher, der Annahme und Verarbeitung entkoppelt |
| Rückstau | Das Bremsen der Annahme, wenn die Verarbeitung nicht nachkommt |
| Messreihendatenbank | Auf fortlaufende Messwerte zugeschnittene Ablage |
| Kardinalität | Zahl der unterschiedlichen Merkmalskombinationen; begrenzt die Ablage |
| Verdichtung | Zusammenfassen alter Werte auf gröbere Zeitraster |
| Nachzügler | Ein Wert, der nach jüngeren Werten eintrifft |
| Mandantentrennung | Sicherstellung, dass jeder nur seine eigenen Daten sieht |
| Qualitätskennzeichen | Angabe, ob ein Wert gültig, geschätzt oder unsicher ist |
Was typischerweise schiefgeht
- Den Zeitstempel beim Eintreffen setzen. Macht nachgelieferte Werte unbrauchbar, und zwar unbemerkt.
- Keine Warteschlange vorsehen. Der erste größere Ausfall kostet dann Daten.
- Merkmale mit vielen Werten verwenden. Die Ablage wird über Wochen langsam, ohne erkennbaren Grund.
- Keine Aufbewahrungsregel festlegen. Der Speicherplatz ist der erste Posten, der bricht.
- Auswertungen auf rohen Daten aufbauen. Der größte einzelne Kostentreiber.
- Mandantentrennung in der Oberfläche. Keine Trennung, sondern deren Anschein.
- Lücken in Kurven durchziehen. Behauptet Messwerte, die es nicht gibt.
- Keine Überwachung der Eingangsrate. Ein Ausfall sieht dann aus wie Ruhe.
Wenn Sie eines mitnehmen
Die Schwierigkeit eines solchen Systems liegt nicht im guten Fall, sondern in dem, was nach einer Störung passiert — wenn eine ganze Flotte gleichzeitig ihre gepufferten Werte abliefert. Wer die Strecke daraufhin entwirft, hat den größeren Teil der Arbeit getan.
Die zweite Erkenntnis betrifft die Kosten: Sie entstehen nicht beim Speichern, sondern beim Abfragen. Eine früh festgelegte Verdichtungsregel und Auswertungen, die auf verdichtete Daten zugreifen, sind der wirksamste Hebel — und sie lassen sich nur einbauen, solange die Daten noch vollständig da sind. Wie sich das in eine größere Datenhaltung einfügt, beschreiben wir unter OT/IT-Integration.
Wie wir dabei unterstützen
Wir entwerfen und bauen die Strecke vom Gerät bis zur Auswertung: Annahme, Verarbeitung, Ablage, Auswertungen, Meldungen und Geräteverwaltung. Wir legen Datenmodell, Benennung und Aufbewahrung so fest, dass der Bestand in Jahren noch auswertbar ist, und rechnen die zu erwartenden Betriebskosten aus, bevor gebaut wird.
Wir bauen so, dass Sie es ohne uns betreiben und ändern können — insbesondere die Auswertungen, weil ein System, dessen Ansichten sich nicht ändern lassen, innerhalb eines Jahres nicht mehr zu den Fragen passt, die gestellt werden.
Weiterführend: Industrielle Edge-Gateways, Maschinendaten erfassen und auswerten, OT/IT-Integration und OPC UA, MQTT und Modbus im Vergleich. Die englischsprachige Fassung finden Sie unter Cloud backends and dashboards for device data.
Häufige Fragen
Was Auftraggeber vorab fragen
Können wir eine gewöhnliche Datenbank für Gerätedaten verwenden?
Am Anfang ja, und für viele Vorhaben dauerhaft. Eine gewöhnliche relationale Datenbank verkraftet einige Millionen Messwerte ohne Weiteres, und bei zehn Geräten mit einem Wert je Minute dauert es Jahre, bis das erreicht ist. Schwierig wird es bei zwei Dingen: wenn die Zahl der Werte so wächst, dass Abfragen über lange Zeiträume langsam werden, und wenn viele verschiedene Merkmalskombinationen entstehen. Eine auf Messreihen ausgelegte Datenbank löst beides, bringt aber eigenen Betriebsaufwand mit. Der brauchbare Weg ist, einfach anzufangen und die Ablage so zu kapseln, dass ein späterer Wechsel nicht das ganze System berührt.
Selbst bauen oder eine Plattform kaufen?
Das hängt weniger an der Technik als am Zeitpunkt und an der Ungewöhnlichkeit der Anforderungen. Eine Plattform liefert in Tagen eine Oberfläche und viele Funktionen, von denen die meisten ungenutzt bleiben; sie lohnt sich, solange die Anforderungen gewöhnlich sind, und ihre Kosten wachsen mit der Zahl der Geräte oder Messgrößen. Ein eigener Aufbau kostet mehr Zeit am Anfang und weniger im Betrieb, und er passt sich an Eigenheiten an. Unser Rat ist, mit einer Plattform oder einem einfachen Eigenbau anzufangen und die Entscheidung erst zu treffen, wenn bekannt ist, welche Daten tatsächlich anfallen und wer damit arbeitet.
Was treibt die Kosten in der Cloud tatsächlich?
Selten das, was man erwartet. Die Speicherung roher Messwerte ist erstaunlich billig; teuer sind Abfragen über große Zeiträume, ausgehender Datenverkehr, verwaltete Dienste mit Bereitstellungspreis je Stunde und jede Komponente, die dauerhaft läuft, obwohl sie nur gelegentlich gebraucht wird. Eine Auswertung, die sich alle dreißig Sekunden selbst aktualisiert und dabei ein Jahr an Daten durchsucht, kostet mehr als die gesamte Speicherung. Wer Verdichtung und Aktualisierungsintervalle bewusst festlegt, senkt die Rechnung regelmäßig um mehr als die Hälfte.
Was ist Kardinalität und warum ist sie wichtig?
Kardinalität ist die Zahl der unterschiedlichen Kombinationen von Merkmalen, unter denen Messwerte abgelegt werden — Gerät mal Messgröße mal Standort mal Charge und so weiter. Messreihendatenbanken legen je Kombination eine eigene Reihe an, und ihr Speicherbedarf und ihre Abfragezeit hängen an dieser Zahl. Das wird zum Problem, wenn ein Merkmal aufgenommen wird, das viele Werte annimmt: eine Seriennummer, eine Chargennummer, eine Auftragsnummer. Aus tausend Reihen werden dann Millionen, und das System wird über Wochen langsam, ohne dass sich die Datenmenge erkennbar geändert hätte.
Brauchen wir die Cloud überhaupt?
Nicht zwingend. Wo alle Beteiligten am selben Standort sind, die Datenmenge überschaubar bleibt und keine Zugriffe von außen nötig sind, ist ein Rechner im eigenen Haus einfacher, billiger und häufig schneller. Die Cloud lohnt sich, wo Standorte verteilt sind, wo die Last stark schwankt, wo Zugriff von außen gebraucht wird oder wo niemand im Haus Server betreuen möchte. Eine verbreitete und vernünftige Anordnung ist beides: Verarbeitung und Pufferung nahe der Anlage, Langzeitablage und standortübergreifende Auswertung außerhalb.
Wie lange sollten wir die Daten aufbewahren?
In verschiedenen Auflösungen verschieden lang. Bewährt hat sich, die volle Auflösung für einige Wochen bis Monate zu halten, danach auf Minuten- oder Stundenwerte zu verdichten und diese für Jahre zu behalten. Das reduziert die Menge um mehr als eine Größenordnung und erhält alles, was in Auswertungen tatsächlich gefragt wird. Wichtig ist, diese Regel früh festzulegen: Verdichten lässt sich nur, was noch vorhanden ist, und wer erst nach drei Jahren darüber nachdenkt, hat die Wahl bereits verloren.
Wie gehen wir mit Werten um, die verspätet eintreffen?
Indem Sie damit rechnen, dass es geschieht — bei gepufferten Geräten nach einer Verbindungsunterbrechung ist es der Normalfall. Zwei Festlegungen lösen das Meiste. Erstens muss der Zeitstempel zum Messwert gehören und nicht zum Zeitpunkt des Eintreffens, sonst landen nachgelieferte Werte alle in derselben Sekunde. Zweitens braucht jeder Wert eine Kennung aus Gerät, Messgröße und Zeitpunkt, damit eine doppelt gelieferte Messung erkannt und nicht zweimal gezählt wird. Wo bereits verdichtete Werte vorliegen, muss zudem geklärt sein, ob ein Nachzügler eine Neuberechnung auslöst.
Können Kunden nur ihre eigenen Daten sehen?
Ja, und das gehört von Anfang an eingebaut, weil es sich nachträglich nur mit erheblichem Aufwand nachrüsten lässt. Jeder Datensatz trägt eine Zugehörigkeit, und jede Abfrage wird auf diese Zugehörigkeit eingeschränkt — nicht in der Oberfläche, sondern an der Stelle, an der die Daten geholt werden. Wer die Einschränkung nur in der Anzeige vornimmt, hat sie nicht. Bei Produkten, die an mehrere Kunden gehen, ist das die folgenreichste Entwurfsentscheidung des gesamten Systems.
Wie viele Geräte, wie viele Messgrößen?
Beschreiben Sie kurz, wie viele Geräte Sie haben, was sie melden und wer die Auswertung benutzen soll. Daraus lässt sich die Größenordnung des Aufwands in einer halben Stunde abschätzen.