Edge-KI auf Mikrocontrollern: was hineinpasst
Modelle auf Mikrocontrollern: welches Speicherbudget tatsächlich gilt, warum die Vorverarbeitung oft mehr Rechenzeit kostet als das Modell, was Quantisierung wirklich kostet und warum die Daten die eigentliche Beschränkung sind.
Kurz gefasst
- Der Speicher für Zwischenergebnisse ist häufig die eigentliche Grenze, nicht die Modellgröße.
- Die Vorverarbeitung kostet oft mehr Rechenzeit als das Modell. Sie gehört zuerst gemessen.
- Die Daten sind die Beschränkung, nicht die Rechenleistung — und die Streuung zählt mehr als die Menge.
- Nach Geräten aufteilen, nicht zufällig. Sonst sieht jedes Modell besser aus, als es ist.
- Wenn eine Regel genügt, nehmen Sie die Regel. Sie ist erklärbar und braucht keine Trainingsdaten.
Warum ein Modell überhaupt ins Gerät gehört
Die naheliegende Anordnung wäre, Messwerte zu übertragen und außerhalb auszuwerten. Für viele Aufgaben ist sie auch richtig. Es gibt allerdings vier Gründe, die Auswertung stattdessen im Gerät stattfinden zu lassen, und sie sind sämtlich praktischer Natur.
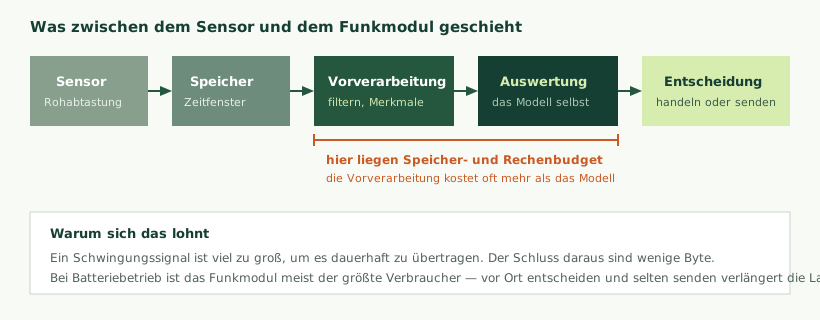
Erstens die Datenmenge. Ein Schwingungssignal, mit zwanzigtausend Werten je Sekunde abgetastet, erzeugt in einer Stunde eine Datenmenge, die sich über keine sparsame Funkverbindung übertragen lässt. Der Schluss daraus — „Lager verhält sich auffällig“ — ist wenige Byte groß. Wer vor Ort auswertet, überträgt das Ergebnis statt der Grundlage, und das ist ein Unterschied um mehrere Größenordnungen.
Zweitens der Strom. Bei einem batteriebetriebenen Gerät ist das Funkmodul in aller Regel der größte Verbraucher. Eine Auswertung im Gerät kostet Rechenzeit, und Rechenzeit ist auf einem Mikrocontroller erstaunlich billig verglichen mit dem Senden. Seltener senden zu können verlängert die Laufzeit unmittelbar.
Drittens die Antwortzeit. Wo eine Reaktion innerhalb von Millisekunden erforderlich ist, kommt ein Weg über eine Verbindung nicht in Frage — unabhängig davon, wie gut diese Verbindung ist.
Viertens die Unabhängigkeit. Ein Gerät, das seine Aufgabe auch bei unterbrochener Verbindung erfüllt, ist betrieblich einfacher zu vertreten. Und wo Rohdaten den Standort nicht verlassen sollen — was in vielen Betrieben eine ernst gemeinte Anforderung ist —, löst die Auswertung vor Ort ein Problem, das sonst Vertragsarbeit wäre.
Was ein Mikrocontroller tatsächlich hat
Bevor über Modelle gesprochen wird, lohnt sich ein nüchterner Blick auf die verfügbaren Mittel. Die Größenordnungen sind für jemanden, der von Entwicklungsrechnern kommt, ungewohnt klein.
| Klasse | Arbeitsspeicher | Programmspeicher | Was hineinpasst |
|---|---|---|---|
| Sehr klein, stromsparend | 16 bis 64 kB | 128 bis 512 kB | Sehr kleine Modelle, einfache Merkmalsauswertung |
| Mittel, mit Signalverarbeitung | 128 bis 512 kB | 512 kB bis 2 MB | Der übliche Bereich für Aufgaben dieser Art |
| Groß, mit Beschleuniger | 512 kB bis 2 MB | 2 bis 8 MB | Kleine Bilderkennung, mehrere Modelle nebeneinander |
| Anwendungsprozessor | ab 256 MB | Speicherkarte | Eine andere Kategorie mit anderem Strombedarf |
Die letzte Zeile ist bewusst enthalten, weil die Entscheidung zwischen Mikrocontroller und Anwendungsprozessor die folgenreichste des ganzen Vorhabens ist. Ein Anwendungsprozessor bietet Speicher im Überfluss und ein vertrautes Betriebssystem — und er braucht mehrere hundert Milliwatt im Betrieb, wo ein Mikrocontroller mit wenigen Milliwatt auskommt. Für ein netzversorgtes Gerät ist das gleichgültig; für ein batteriebetriebenes entscheidet es zwischen Jahren und Tagen.
Das Speicherbudget im Einzelnen
Die Frage „Wie groß darf das Modell sein?“ ist schlecht gestellt, weil vier verschiedene Posten um denselben Speicher konkurrieren. Sie auseinanderzuhalten erspart die häufigste Überraschung solcher Projekte.
- Die Modellparameter liegen im Programmspeicher und werden dort nicht verändert. Bei ganzzahliger Darstellung sind es etwa ein Byte je Parameter. Dieser Posten ist der einzige, der in Angeboten regelmäßig genannt wird.
- Der Arbeitsspeicher für die Auswertung nimmt die Zwischenergebnisse zwischen den Schichten auf. Sein Bedarf richtet sich nach der größten Zwischenschicht, nicht nach der Gesamtgröße des Modells — und er kann ein Vielfaches der Parametergröße betragen. Das ist die Zahl, an der Projekte scheitern.
- Der Zwischenspeicher für das Eingangssignal. Ein Zeitfenster von einer Sekunde bei zwanzigtausend Abtastungen je Sekunde und zwei Byte je Wert belegt vierzig Kilobyte, und zwar allein für die Rohdaten.
- Der Bedarf der Vorverarbeitung. Eine Frequenzzerlegung braucht Platz für ihr Ergebnis, häufig noch einmal in der Größenordnung des Eingangsfensters.
Hinzu kommt der Speicher, den die übrige Gerätesoftware belegt — Funkstapel, Zwischenspeicher für zu sendende Daten, Betriebssystem. Ein Funkstapel allein beansprucht regelmäßig mehrere zehn Kilobyte Arbeitsspeicher, und er lässt sich nicht verhandeln.
Die praktische Folge: Das Speicherbudget für das Modell sollte früh und schriftlich festgelegt werden, und zwar als Rest nach Abzug aller anderen Posten. Ein Modell, das erst am Ende auf einen Baustein gebracht wird, der bereits zu achtzig Prozent belegt ist, führt zu einer unangenehmen Entscheidung zwischen einem teureren Baustein und einem schlechteren Modell.
Auswertungsdauer und das Zeitfenster, in das sie passen muss
Neben dem Speicher ist die zweite Beschränkung die Zeit. Sie ergibt sich nicht aus der Rechenleistung, sondern aus dem Abstand, in dem ausgewertet werden soll.
Die Rechnung ist einfach und wird selten aufgemacht. Wenn alle zweihundert Millisekunden ein Ergebnis vorliegen soll, müssen Abtastung, Vorverarbeitung und Modellauswertung zusammen in weniger als zweihundert Millisekunden erledigt sein — und es muss Reserve bleiben für alles andere, was das Gerät tut: Funk, Selbstüberwachung, Bedienung.
Zwei Beobachtungen aus der Praxis dazu. Erstens: Die Vorverarbeitung kostet häufig mehr Rechenzeit als das Modell selbst. Eine Frequenzzerlegung über ein längeres Fenster, eine Filterung, die Berechnung von Kennwerten — das summiert sich, und es wird bei der Planung regelmäßig übersehen, weil die Aufmerksamkeit dem Modell gilt. Zweitens: Die Auswertung läuft auf dem Zielbaustein anders schnell als auf dem Entwicklungsrechner, und zwar um Größenordnungen. Eine Schätzung, die nicht auf der Zielhardware gemessen wurde, ist keine.
Daraus folgt eine Vorgehensweise, die viel Ärger erspart: Sobald ein erstes, auch schlechtes Modell vorliegt, wird es auf den Zielbaustein gebracht und die Ausführungszeit gemessen — lange bevor an der Genauigkeit gearbeitet wird. Erst diese Messung sagt, ob das Vorhaben in der geplanten Form überhaupt möglich ist.
Quantisierung: der Kompromiss, den Sie eingehen werden
Modelle werden mit Gleitkommazahlen trainiert. Mikrocontroller verarbeiten Ganzzahlen weit besser — viele haben für Gleitkomma überhaupt keine eigene Recheneinheit und rechnen sie mühsam in Software nach. Der Übergang zwischen beiden Welten heißt Quantisierung.
Was sie bringt, ist erheblich: etwa ein Viertel des Speicherbedarfs und eine deutlich kürzere Ausführungszeit. Was sie kostet, ist bei den Aufgaben, um die es hier geht, überraschend wenig — üblich sind Einbußen von einem Prozentpunkt oder darunter.
Worauf dabei zu achten ist:
- Die Umstellung braucht Beispieldaten. Um die Wertebereiche je Schicht festzulegen, wird ein repräsentativer Ausschnitt der Eingangsdaten durch das Modell geschickt. Ist dieser Ausschnitt nicht repräsentativ, entstehen Bereiche, die im Einsatz überschritten werden.
- Die Genauigkeit gehört auf dem Gerät gemessen, nicht auf dem Entwicklungsrechner. Simulationen der Quantisierung sind gut und nicht dasselbe.
- Einzelne Schichten dürfen genauer bleiben. Wo eine Schicht empfindlich reagiert, kostet es wenig Speicher, sie in höherer Genauigkeit zu belassen.
- Die Eingangsdaten müssen zur Erwartung des Modells passen. Der häufigste Fehler an dieser Stelle ist eine Skalierung, die auf dem Entwicklungsrechner anders gerechnet wird als im Gerät — mit dem Ergebnis, dass dasselbe Modell auf demselben Signal unterschiedliche Ergebnisse liefert.
Der letzte Punkt verdient Nachdruck, weil er sich als rätselhafter Genauigkeitsverlust äußert und die Ursache an einer ganz anderen Stelle liegt. Ein Abgleich, bei dem dasselbe Eingangssignal einmal auf dem Rechner und einmal im Gerät durchgerechnet und die Zwischenergebnisse verglichen werden, findet ihn in Minuten.
Die Vorverarbeitung ist keine Nebensache
Zwischen dem Sensor und dem Modell liegt eine Verarbeitung, die über den Erfolg mehr entscheidet als die Wahl des Modells — und die in der Aufmerksamkeit regelmäßig zu kurz kommt.
- Filtern. Alles wegnehmen, was nicht zur Aufgabe gehört: Netzfrequenz, Gleichanteil, Frequenzen oberhalb des Interessanten.
- Fenstern. Das Signal in Abschnitte teilen, mit einer bewussten Entscheidung über Länge und Überlappung. Beides beeinflusst sowohl die Erkennungsleistung als auch den Speicherbedarf unmittelbar.
- Umwandeln. Bei Schwingungen und Geräuschen ist die Frequenzdarstellung fast immer aussagekräftiger als der zeitliche Verlauf — und sie erlaubt ein deutlich kleineres Modell.
- Merkmale bilden. Häufig genügen wenige gut gewählte Kennwerte, und dann braucht es überhaupt kein neuronales Netz mehr.
- Normieren. Auf einen einheitlichen Wertebereich bringen, und zwar genau so, wie es beim Training geschehen ist.
Der vierte Punkt ist derjenige, der Projekte am stärksten vereinfacht und am seltensten geprüft wird. Bevor ein Modell trainiert wird, lohnt sich der Versuch, die Aufgabe mit einer Handvoll berechneter Kennwerte und einer einfachen Entscheidungsregel zu lösen. Gelingt das, ist das Ergebnis kleiner, schneller, erklärbar und braucht keine Trainingsdaten — und es lässt sich einem Instandhalter in zwei Sätzen erklären, was im Betrieb mehr wert ist, als es klingt.
Strom, und die Rechnung, die über die Laufzeit entscheidet
Bei einem batteriebetriebenen Gerät ist die Energiebilanz die Randbedingung, aus der sich alles andere ergibt. Sie hat vier Posten, und ihre Größenverhältnisse überraschen regelmäßig.
| Posten | Größenordnung | Anmerkung |
|---|---|---|
| Ruhezustand | sehr klein je Stunde | Über Jahre summiert er sich dennoch |
| Abtastung | klein bis mittel | Hängt an Abtastrate und Sensor |
| Vorverarbeitung und Auswertung | mittel | Rechenzeit ist billig verglichen mit Funk |
| Übertragung | groß | Fast immer der größte Posten |
Aus dieser Verteilung folgt die eigentliche Begründung für die Auswertung im Gerät: Es lohnt sich, mehr zu rechnen, um weniger zu senden. Ein Gerät, das jede Minute ein Signal auswertet und nur bei einer Auffälligkeit meldet, verbraucht deutlich weniger als eines, das jede Minute Rohdaten überträgt — selbst wenn die Auswertung erheblich Rechenzeit kostet.
Zwei Punkte, die in Laborrechnungen fehlen und im Feld zuschlagen: Batterien verlieren bei Kälte einen erheblichen Teil ihrer nutzbaren Kapazität, und ein Gerät mit schlechter Funkverbindung sendet wiederholt, wodurch der größte Posten noch größer wird. Eine Laufzeitrechnung bei Zimmertemperatur und guter Verbindung ist deshalb eine Obergrenze und keine Planung.
Welche Aufgaben dafür taugen
Nicht jede Frage lässt sich auf einem Mikrocontroller beantworten, und es lohnt sich, die Grenze scharf zu ziehen, bevor Aufwand entsteht.
Gut geeignet sind Aufgaben mit wenigen, klar unterscheidbaren Ausgängen, einem überschaubaren Eingangssignal und einer Umgebung, die sich nicht ständig ändert:
- Den Betriebszustand einer Maschine aus einem Schwingungs- oder Stromsignal erkennen — läuft, steht, läuft ungewöhnlich.
- Eine Abweichung vom gewohnten Verhalten melden, ohne vorher zu wissen, welche Art von Abweichung es sein wird.
- Ein Schlüsselwort in Sprache erkennen, damit ein Gerät ohne Dauerverbindung bedienbar wird.
- Eine einfache Bewegung oder Geste aus Beschleunigungsdaten unterscheiden.
- Ein Ereignis zählen, das sich von anderen Ereignissen zuverlässig unterscheidet.
- Eine grobe Sichtprüfung bei fester Beleuchtung und festem Bildausschnitt — vorhanden oder fehlend, richtig oder falsch herum.
Schlecht geeignet sind Aufgaben, die allgemeines Verstehen verlangen oder deren Bedingungen stark schwanken: freies Sprachverstehen, Erkennung beliebiger Objekte in beliebiger Umgebung, Aufgaben mit vielen Dutzend zu unterscheidenden Fällen, und alles, wofür keine Beispieldaten beschafft werden können.
Ein Grenzfall verdient eigene Erwähnung, weil er häufig angefragt wird: die Vorhersage eines Ausfalls. Sie setzt voraus, dass genügend dokumentierte Ausfälle mit den zugehörigen Messwerten davor vorliegen — und das ist in den meisten Betrieben zu Beginn nicht der Fall. Die Erkennung einer Abweichung vom Normalzustand braucht dagegen keine Ausfallbeispiele und beantwortet die praktisch wichtigere Frage. Wie sich das einordnet, behandeln wir unter Vorausschauende Wartung.
Ihre Daten sind die Beschränkung, nicht der Baustein
Die häufigste Fehleinschätzung in solchen Vorhaben betrifft nicht die Technik, sondern die Voraussetzung: Es wird angenommen, die Schwierigkeit liege im Modell oder im Baustein. Tatsächlich liegt sie fast immer bei den Daten.
Der Grund ist einfach. Ein Modell lernt genau das, was in den Beispielen steckt. Wenn alle Beispiele von einem Gerät stammen, lernt es dieses Gerät. Wenn alle bei zwanzig Grad aufgenommen wurden, lernt es zwanzig Grad. Wenn die Beispiele für „auffällig“ alle an einem Tag entstanden, an dem zufällig auch etwas anderes anders war, lernt es dieses andere.
Das ist kein theoretisches Risiko. Es ist das wiederkehrende Muster, in dem solche Projekte scheitern: Ein Modell, das im Versuch hervorragende Werte erreicht, verliert im Feld den größten Teil seiner Leistung — und die Ursache lässt sich im Nachhinein nur mit erheblichem Aufwand finden.
Den Datensatz entwerfen
Weil die Daten die Beschränkung sind, verdient ihre Beschaffung mehr Planung als das Modell. Vier Punkte machen den Unterschied.
Über die Streuung hinweg aufnehmen, die tatsächlich auftreten wird
Der Datensatz muss die Vielfalt abbilden, die im Einsatz vorkommt. Konkret heißt das:
- Mehrere Exemplare desselben Geräts oder derselben Maschine — Fertigungsstreuung ist real und überraschend groß.
- Verschiedene Einbaulagen und Befestigungen, weil ein um wenige Zentimeter versetzter Aufnehmer ein anderes Signal liefert.
- Verschiedene Temperaturen, weil nahezu alles temperaturabhängig ist.
- Verschiedene Betriebszustände: Anlauf, Vollast, Teillast, Leerlauf, unmittelbar nach einer Wartung.
- Verschiedene Zeiten — über Wochen statt an einem Tag, weil sich sonst Umstände einschleichen, die niemand notiert hat.
Die Regel dazu lässt sich in einem Satz sagen: Zweihundert Beispiele von zehn Geräten sind mehr wert als tausend von einem. Die Streuung ist die Aufgabe, nicht die Menge.
Nach Gerät aufteilen, nicht zufällig
Beim Bewerten wird der Datensatz in einen Teil zum Lernen und einen zum Prüfen geteilt. Wird zufällig geteilt, landen Aufnahmen desselben Geräts in beiden Teilen — und das Modell erkennt im Prüfteil Geräte wieder, die es bereits kennt. Das Ergebnis sieht hervorragend aus und sagt nichts darüber aus, wie das Modell auf einem neuen Gerät abschneidet.
Richtig ist, nach Gerät zu teilen: alle Aufnahmen eines Geräts kommen entweder in den Lernteil oder in den Prüfteil, nie in beide. Die Werte fallen dann schlechter aus, und sie sind die ersten, die etwas bedeuten.
Dasselbe gilt für die Zeit: Wo sich Bedingungen über Wochen verändern, gehört der Prüfteil aus einem späteren Zeitraum als der Lernteil. Ein Modell, das an Daten vom Januar geprüft wird und an Daten vom Januar gelernt hat, sagt nichts über den Juli.
Sorgfältig kennzeichnen und festhalten, was die Kennzeichnung bedeutet
Die Kennzeichnung der Beispiele ist der langweiligste und folgenreichste Teil der Arbeit. Zwei Fragen entscheiden über ihre Brauchbarkeit.
Was genau bedeutet die Kennzeichnung? „Auffällig“ ist keine Festlegung. „Schwingungspegel im Band 2 bis 5 kHz um mehr als das Doppelte über dem Ausgangszustand, festgestellt und bestätigt von der Instandhaltung“ ist eine. Ohne diese Festlegung kennzeichnen zwei Personen unterschiedlich, und das Modell lernt die Uneinigkeit.
Wer hat gekennzeichnet, und stimmen sie überein? Wo es möglich ist, lohnt es sich, einen Teil der Beispiele von zwei Personen unabhängig kennzeichnen zu lassen und die Übereinstimmung zu messen. Liegt sie bei achtzig Prozent, ist achtzig Prozent auch die Obergrenze für das Modell — und das zu wissen, bevor drei Monate Arbeit hineinfließen, ist wertvoll.
Anreichern, aber mit Bedacht
Vorhandene Beispiele lassen sich künstlich vervielfachen — durch Verschieben, Skalieren, Hinzufügen von Rauschen. Das hilft, wenn die Veränderungen solchen entsprechen, die im Einsatz tatsächlich vorkommen.
Es schadet, wenn sie es nicht tun. Ein Schwingungssignal um einen Faktor zu strecken bildet eine andere Drehzahl nach — sinnvoll, wenn die Maschine tatsächlich mit verschiedenen Drehzahlen läuft, irreführend, wenn sie es nicht tut. Die Frage lautet immer: Entspricht diese Veränderung etwas, das in der Wirklichkeit vorkommt?
Was das Anreichern nicht leisten kann, ist das Ersetzen fehlender Vielfalt. Aus Aufnahmen eines einzigen Geräts lassen sich keine Aufnahmen zehn verschiedener Geräte erzeugen, egal wie geschickt verändert wird.
Ehrlich bewerten
Die Genauigkeit als einzelne Zahl ist bei den meisten dieser Aufgaben irreführend, und zwar gefährlich irreführend. Wenn ein gesuchtes Ereignis in einem Prozent der Fälle auftritt, erreicht ein Modell, das immer „nichts besonderes“ sagt, neunundneunzig Prozent Genauigkeit — und ist vollkommen wertlos.
Brauchbar sind stattdessen:
- Die Verwechslungstabelle, die zeigt, welche Fälle mit welchen anderen verwechselt werden. Sie beantwortet die Frage, welche Art von Fehler das Modell macht.
- Trefferquote und Genauigkeit getrennt: Wie viele der tatsächlichen Ereignisse werden gefunden, und wie viele der Meldungen sind berechtigt?
- Die Betrachtung der Schwelle. Ein Modell liefert keine Entscheidung, sondern eine Zahl. Wo die Schwelle liegt, entscheidet über das Verhältnis von übersehenen Ereignissen zu Fehlalarmen — und diese Entscheidung ist keine technische, sondern eine betriebliche.
- Die Leistung je Gerät, nicht nur über alle. Ein Modell, das bei neun Geräten gut und bei einem schlecht arbeitet, hat im Mittel gute Werte und im Feld ein Problem.
Der dritte Punkt gehört ausdrücklich mit dem Betreiber besprochen. Die Frage „Was ist schlimmer — ein übersehener Ausfall oder zehn Fehlalarme?“ hat je nach Anlage eine andere Antwort, und sie zu klären ist Teil der Arbeit.
Prüfen, bevor es ausgeliefert wird
Zwischen einem Modell, das auf dem Rechner gute Werte erreicht, und einem Gerät, dem man vertrauen kann, liegen einige Prüfungen, die zusammen wenige Tage kosten.
- Dasselbe Signal auf Rechner und Gerät durchrechnen und die Zwischenergebnisse vergleichen. Findet Skalierungs- und Quantisierungsfehler in Minuten.
- Auf Gerätedaten prüfen, die nie im Training vorkamen — am besten von einem Gerät, das erst nach Abschluss des Trainings gebaut wurde.
- Die Ausführungszeit im ungünstigsten Fall messen, nicht im Mittel. Ein gelegentlich zu langsamer Durchlauf ist ein Fehler, kein Ausreißer.
- Den Speicherbedarf zur Laufzeit prüfen, mit allem, was sonst noch läuft — Funk, Bedienung, Selbstüberwachung.
- Über Temperatur prüfen. Sensoren driften, und ein Modell, das auf ungedrifteten Daten gelernt hat, verliert bei Kälte oder Wärme an Leistung.
- Das Verhalten bei unsinnigen Eingaben prüfen. Was tut das Gerät, wenn der Sensor abgefallen ist? Ein Modell liefert immer eine Antwort, auch auf Unsinn.
- Über Tage im Feld laufen lassen, ohne dass eine Entscheidung davon abhängt, und die Ergebnisse mit der Wirklichkeit vergleichen.
Der sechste Punkt ist derjenige, der am häufigsten fehlt und im Feld am meisten kostet. Ein Modell hat keine Möglichkeit, „das kenne ich nicht“ zu sagen — es ordnet jede Eingabe einer der gelernten Möglichkeiten zu. Eine vorgeschaltete Plausibilitätsprüfung des Eingangssignals, die offensichtlichen Unsinn abfängt, bevor das Modell überhaupt aufgerufen wird, ist deshalb kein Beiwerk, sondern Teil des Entwurfs.
Modelle nach der Auslieferung am Leben halten
Ein Modell ist keine Software, die einmal richtig ist und dann richtig bleibt. Die Wirklichkeit, auf die es angewendet wird, verändert sich — neue Maschinenvarianten, andere Betriebsweisen, gealterte Sensoren, ein anderer Lieferant für ein Bauteil.
Was dafür vorgesehen sein sollte:
- Das Modell als austauschbarer Bereich im Speicher, getrennt von der übrigen Gerätesoftware, mit Versionsnummer und Prüfsumme.
- Die Modellversion bei jedem Ergebnis mitführen, sonst lässt sich später nicht feststellen, welche Aussage von welchem Stand stammt.
- Stufenweises Ausrollen mit einem Weg zurück — eine fehlerhafte Aktualisierung, die gleichzeitig an alle Geräte geht, ist der teuerste vermeidbare Zwischenfall.
- Eine Rückmeldung aus dem Feld. Wie oft meldet das Gerät etwas, und war es berechtigt? Ohne diese Rückmeldung ist eine Verschlechterung nicht zu bemerken.
- Gelegentliche Rohdatenaufnahmen, ausgelöst durch Zufall oder durch einen Grenzfall, als Grundlage für spätere Verbesserungen.
Der letzte Punkt ist ungewöhnlich wertvoll und kostet wenig: Ein Gerät, das gelegentlich ein vollständiges Eingangsfenster mit hochlädt — insbesondere dann, wenn das Modell unsicher war —, liefert über ein Jahr genau die Beispiele, die beim ersten Training gefehlt haben.
Bildverarbeitung im Gerät, gesondert betrachtet
Bilder sind ein Sonderfall, weil ihre Datenmenge alles andere in den Schatten stellt. Ein Bild mit 320 mal 240 Bildpunkten in Graustufen belegt bereits fünfundsiebzigtausend Byte — mehr Arbeitsspeicher, als viele Mikrocontroller überhaupt besitzen, und das nur für ein einziges Bild.
Daraus folgen mehrere Einschränkungen, die den Entwurf bestimmen:
- Die Auflösung wird klein. Für Aufgaben dieser Art sind Bilder mit wenigen zehntausend Bildpunkten üblich — genug für „vorhanden oder fehlend“, nicht genug für feine Details.
- Der Bildausschnitt muss fest sein. Kamera, Abstand und Blickwinkel dürfen sich nicht ändern, sonst passt das Modell nicht mehr.
- Die Beleuchtung ist die halbe Miete. Eine eigene, konstante Beleuchtung löst mehr Probleme als jede Verbesserung am Modell — und sie ist billiger.
- Das Bild wird zeilenweise verarbeitet, wo es geht, weil ein vollständiges Bild im Speicher zu halten häufig nicht möglich ist.
- Der Strombedarf steigt deutlich. Bildsensoren und die zugehörige Verarbeitung sind für Batteriebetrieb nur bei sehr seltenen Aufnahmen geeignet.
Die dritte Zeile verdient Nachdruck, weil sie den größten Hebel beschreibt. Ein erheblicher Teil dessen, was als schwierige Erkennungsaufgabe erscheint, ist in Wirklichkeit ein Beleuchtungsproblem. Eine feste, gerichtete Beleuchtung, die Schatten und Reflexe beseitigt, verwandelt eine Aufgabe, für die ein großes Modell nötig wäre, regelmäßig in eine, die mit einer Schwellwertbetrachtung lösbar ist.
Schützen, was auf dem Gerät liegt
Ein trainiertes Modell ist Arbeitsergebnis und häufig das eigentliche Unterscheidungsmerkmal eines Produkts. Es liegt im Speicher eines Geräts, das jemand in die Hand nehmen kann.
Ein vollständiger Schutz ist nicht erreichbar, und es ist nützlich, das offen zu sagen. Erreichbar ist, den Aufwand für das Auslesen so weit zu erhöhen, dass er sich nicht lohnt:
- Die Ausleseschutzfunktion des Bausteins aktivieren — sie ist vorhanden und wird bei Serienstart regelmäßig vergessen.
- Die Programmierschnittstelle in der Serie abschalten oder mit einem Geheimnis versehen.
- Das Modell verschlüsselt ablegen und erst zur Laufzeit entschlüsseln, wo der Baustein das unterstützt.
- Die Vorverarbeitung mitbedenken. Häufig steckt mehr Arbeitsergebnis in den Merkmalen als im Modell selbst.
- Abwägen, was schützenswert ist. Bei vielen Anwendungen ist das Modell ohne die passenden Sensoren und ihre Anordnung wertlos — dann ist der Aufwand für Schutz besser anderswo angelegt.
Ein Wort zur Erklärbarkeit
In der Halle wird eine Meldung nur dann befolgt, wenn sie sich begründen lässt. Ein Gerät, das „Auffälligkeit erkannt“ meldet und sonst nichts, wird nach der dritten unbestätigten Meldung ignoriert — unabhängig davon, wie gut das Modell tatsächlich ist.
Dagegen hilft weniger ein besseres Modell als eine bessere Meldung. Drei Angaben genügen meist: welcher Wert die Meldung ausgelöst hat, wie weit er vom gewohnten Bereich abweicht, und seit wann sich die Abweichung aufbaut. Diese Angaben liegen ohnehin vor und kosten nur wenige Byte mehr in der Übertragung.
Wo ein Modell Merkmale auswertet, die aus dem Signal berechnet wurden, lässt sich zusätzlich benennen, welches Merkmal am stärksten zur Entscheidung beigetragen hat. Das ist keine vollständige Erklärung, und es reicht in der Praxis fast immer aus — weil jemand, der die Maschine kennt, mit dem Hinweis „der Anteil im hohen Frequenzband ist seit vier Tagen erhöht“ etwas anfangen kann, mit einer bloßen Warnung dagegen nicht.
Wann die ehrliche Antwort Nein lautet
Es lohnt sich, die Fälle zu benennen, in denen dieser Ansatz nicht der richtige ist — und sie kommen häufiger vor, als Anbieter nahelegen.
Wenn eine Regel dasselbe leistet. Ein Schwellwert auf einem Frequenzband, ein Vergleich mit dem Vortag, eine Bedingung aus zwei Messgrößen: Solche Verfahren sind nachvollziehbar, brauchen keine Trainingsdaten, lassen sich vor Ort erklären und ändern sich nicht unerwartet. Wenn sie ausreichen, sind sie besser.
Wenn keine Beispiele beschafft werden können. Ohne Daten kein Modell — und Daten, die es noch nicht gibt, lassen sich nicht durch Aufwand ersetzen. In solchen Fällen ist der erste Schritt, sauber zu erfassen und zu dokumentieren, und die Auswertung folgt in einem Jahr.
Wenn das gesuchte Ereignis zu selten ist. Ein Ausfall, der alle drei Jahre einmal vorkommt, liefert in fünf Jahren Betrieb ein oder zwei Beispiele. Daraus lässt sich nichts lernen. Die Erkennung einer Abweichung vom Normalzustand ist dann der gangbare Weg.
Wenn die Entscheidung erklärbar sein muss. Wo eine Meldung eine Handlung mit erheblichen Folgen auslöst und jemand sie verantworten muss, ist ein nachvollziehbares Verfahren einem besseren, aber undurchsichtigen vorzuziehen.
Ein Dienstleister, der diese Fälle von sich aus anspricht, spart Ihnen mehr Geld als einer, der in jedem Fall ein Modell vorschlägt.
Drei durchgerechnete Fälle
Einen bestimmten Maschinenzustand aus Schwingungen erkennen
Aufgabe: An einer Presse soll erkannt werden, wann ein Werkzeug stumpf wird — erkennbar an einer Veränderung im Schwingungsverlauf während des Umformvorgangs.
Abtastung mit zehntausend Werten je Sekunde über ein Fenster von einer Viertelsekunde, Frequenzzerlegung, daraus rund vierzig Kennwerte, und ein sehr kleines Modell mit einigen tausend Parametern. Speicherbedarf insgesamt unter fünfzig Kilobyte, Auswertung in wenigen Millisekunden — auf einem gewöhnlichen Mikrocontroller ohne Beschleuniger.
Der Aufwand lag vollständig bei den Daten: Es mussten Werkzeuge über ihre gesamte Standzeit begleitet werden, mit einer Kennzeichnung durch den Einrichter, wann ein Werkzeug tatsächlich zu tauschen war. Das dauerte vier Monate und war die eigentliche Arbeit.
Ein Batteriesensor, der ein ungewöhnliches Ereignis meldet
Aufgabe: Ein batteriebetriebener Sensor an einer Pumpe soll melden, wenn sich das Verhalten verändert — ohne zu wissen, welche Art von Veränderung.
Hier kommt kein Klassifikationsmodell in Frage, sondern eine Abweichungserkennung: Das Gerät lernt in den ersten Wochen den Normalzustand und meldet, wenn der aktuelle Zustand davon merklich abweicht. Das braucht keine Ausfallbeispiele, und es lässt sich mit sehr wenig Speicher umsetzen.
Die Schwierigkeit lag anderswo — beim Normalzustand selbst. Die Pumpe lief in drei verschiedenen Betriebspunkten, und was im einen normal ist, ist im anderen auffällig. Gelöst wurde das, indem der Betriebspunkt zuerst bestimmt und je Betriebspunkt ein eigener Normalzustand geführt wurde.
Eine grobe Sichtprüfung
Aufgabe: An einer Montagelinie soll geprüft werden, ob ein Bauteil vorhanden und richtig herum eingelegt ist.
Diese Aufgabe wäre mit einem Modell lösbar und war es am Ende nicht. Eine feste, gerichtete Beleuchtung und ein fester Bildausschnitt reduzierten die Frage auf zwei Helligkeitsbereiche im Bild — lösbar mit zwei Schwellwerten, ohne Modell, ohne Trainingsdaten und in wenigen Millisekunden.
Dieser Fall steht hier, weil er das häufigste und am seltensten geprüfte Ergebnis einer solchen Untersuchung beschreibt: dass die Aufgabe durch eine Veränderung der Aufnahmebedingungen einfacher wird, statt durch ein besseres Verfahren.
Werkzeugketten, kurz
Für die Umsetzung gibt es mehrere Wege, und sie unterscheiden sich vor allem darin, wie viel Kontrolle sie abgeben.
- Anbieterunabhängige Laufzeitumgebungen nehmen ein trainiertes Modell entgegen und führen es auf dem Mikrocontroller aus. Verbreitet, gut dokumentiert, und der übliche Ausgangspunkt.
- Werkzeuge der Halbleiterhersteller erzeugen daraus Code, der auf ihre Bausteine zugeschnitten ist — schneller und sparsamer, dafür an den Hersteller gebunden.
- Vollständige Plattformen decken Datenerfassung, Kennzeichnung, Training und Bereitstellung ab. Sehr schnell zu einem ersten Ergebnis, mit Abhängigkeit und laufenden Kosten.
- Eigene Umsetzung. Bei sehr kleinen Modellen durchaus vertretbar und manchmal die sparsamste Lösung.
Unser Rat ist, mit einer anbieterunabhängigen Umgebung zu beginnen und erst dann auf herstellerspezifische Werkzeuge zu wechseln, wenn die Messung auf der Zielhardware zeigt, dass es nötig ist. Die Bindung, die dabei entsteht, ist real und sollte bewusst eingegangen werden.
Wie ein solches Vorhaben abläuft
Die Reihenfolge der Schritte ist bei diesen Projekten wichtiger als bei gewöhnlicher Softwareentwicklung, weil ein früher Fehler erst sehr spät sichtbar wird. Bewährt hat sich diese Abfolge:
- Die Frage schärfen. Welche Unterscheidung soll getroffen werden, wie oft, und was geschieht mit dem Ergebnis? Eine Aufgabe mit zwei Ausgängen ist deutlich einfacher als eine mit acht — und häufig genügt sie.
- Prüfen, ob eine Regel reicht. Ein halber Tag, der regelmäßig Monate spart.
- Das Budget festlegen. Speicher, Zeit, Strom — als Zahlen, schriftlich, vor der ersten Zeile Code.
- Daten erfassen, mit einer bewussten Planung der Streuung: mehrere Geräte, mehrere Bedingungen, über Wochen.
- Kennzeichnen, mit einer schriftlichen Festlegung, was die Kennzeichnung bedeutet, und einer Prüfung der Übereinstimmung zwischen zwei Personen.
- Ein erstes, schlechtes Modell auf die Zielhardware bringen und Zeit und Speicher messen. Dieser Schritt kommt früh, nicht spät.
- Vorverarbeitung und Modell gemeinsam verbessern, innerhalb des festgelegten Budgets.
- Quantisieren und auf dem Gerät nachmessen.
- Prüfen, nach der weiter oben beschriebenen Liste.
- Im Feld laufen lassen, zunächst ohne dass eine Entscheidung davon abhängt.
Der sechste Schritt ist der ungewöhnliche und der wichtigste. Die übliche Vorgehensweise wäre, erst ein gutes Modell zu entwickeln und es dann auf das Gerät zu bringen — und dort festzustellen, dass es weder in den Speicher passt noch schnell genug läuft. Wer die Reihenfolge umdreht, entwickelt von Anfang an innerhalb der tatsächlichen Grenzen.
Fragen, die sich an jeden Anbieter lohnen
- Wie viel Arbeitsspeicher braucht die Auswertung zur Laufzeit, nicht nur wie groß das Modell ist?
- Wie lange dauert ein Durchlauf auf dem vorgesehenen Baustein, im ungünstigsten Fall gemessen?
- Wie wurde der Datensatz aufgeteilt — zufällig oder nach Gerät?
- Von wie vielen verschiedenen Geräten stammen die Daten?
- Wie verhält sich das Modell bei einer Eingabe, die es nie gesehen hat?
- Wie wird das Modell später ausgetauscht, und was passiert bei einer fehlerhaften Aktualisierung?
- Was gehört uns am Ende — der trainierte Stand, die Daten, die Vorverarbeitung, das Werkzeug zum Nachtrainieren?
Die letzte Frage ist die kaufmännisch wichtigste und wird am seltensten gestellt. Ein Modell ohne die zugehörigen Daten und ohne den Weg, es neu zu trainieren, ist eine einmalige Lieferung — und wenn sich die Bedingungen in zwei Jahren ändern, beginnt alles von vorn.
Wo solche Vorhaben in der Regel stocken
Die Stellen sind erstaunlich beständig, und sie liegen sämtlich nicht in der Technik:
- Beim Beschaffen der Daten. Es dauert länger als geplant, weil die interessanten Zustände selten auftreten und die Maschine nicht für Versuche zur Verfügung steht.
- Beim Kennzeichnen. Die Person, die beurteilen kann, was ein Signal bedeutet, ist die Person, die am wenigsten Zeit hat.
- Bei der Einigung über die Schwelle. Die Frage, ob lieber Ereignisse übersehen oder Fehlalarme in Kauf genommen werden, ist betrieblich und wird gern aufgeschoben.
- Beim Übergang ins Feld. Das Modell arbeitet, aber niemand hat festgelegt, was bei einer Meldung geschieht.
- Beim Nachtrainieren. Nach einem Jahr passt das Modell nicht mehr, und die Daten für ein neues Training wurden nicht gesammelt.
Gegen die erste und die letzte Stelle hilft dieselbe Maßnahme, und sie kostet fast nichts: Von Anfang an Rohdaten sammeln, auch bevor überhaupt klar ist, wozu — und insbesondere dann, wenn etwas Ungewöhnliches passiert ist. Ein Jahr Aufzeichnung ist die beste Ausgangslage, die ein solches Vorhaben haben kann, und sie entsteht nur, wenn jemand früh damit anfängt.
Kleines Glossar
| Begriff | Was gemeint ist |
|---|---|
| Auswertung im Gerät | Das Anwenden eines trainierten Modells auf dem Gerät selbst |
| Quantisierung | Umstellung von Gleitkomma auf Ganzzahlen; spart Speicher und Zeit |
| Parameter | Die gelernten Zahlen eines Modells; bestimmen seine Größe |
| Zwischenspeicher der Auswertung | Arbeitsspeicher für Zwischenergebnisse; oft die eigentliche Grenze |
| Merkmale | Aus dem Rohsignal berechnete Kennwerte, die dem Modell vorgelegt werden |
| Abweichungserkennung | Meldung, dass etwas vom Gelernten abweicht, ohne zu wissen was |
| Verwechslungstabelle | Übersicht, welche Fälle mit welchen verwechselt werden |
| Schwelle | Der Wert, ab dem aus einer Zahl eine Entscheidung wird |
Was typischerweise schiefgeht
- Nur die Modellgröße betrachten. Der Zwischenspeicher der Auswertung ist häufig die härtere Grenze.
- Die Vorverarbeitung vergessen. Sie kostet oft mehr Rechenzeit und Speicher als das Modell.
- Die Ausführungszeit nicht auf der Zielhardware messen. Schätzungen liegen um Größenordnungen daneben.
- Zufällig aufteilen statt nach Gerät. Erzeugt hervorragende Werte ohne Aussagekraft.
- Alle Daten von einem Gerät nehmen. Das Modell lernt dieses Gerät.
- Die Genauigkeit als einzige Zahl betrachten. Bei seltenen Ereignissen irreführend.
- Keine Plausibilitätsprüfung der Eingabe. Ein Modell antwortet auch auf Unsinn.
- Kein Weg für Modellaktualisierungen. Nachträglich kaum nachzurüsten.
Wenn Sie eines mitnehmen
Die Beschränkung liegt nicht beim Baustein, sondern bei den Daten — und innerhalb der Technik nicht beim Modell, sondern beim Arbeitsspeicher für die Auswertung und bei der Vorverarbeitung. Wer diese drei früh misst statt zu schätzen, weiß nach zwei Wochen, ob das Vorhaben tragfähig ist.
Und wenn eine Regel dasselbe leistet wie ein Modell, nehmen Sie die Regel. Sie ist kleiner, schneller, erklärbar und braucht niemanden, der sie nach zwei Jahren neu trainiert. Wie sich solche Verfahren in eine Zustandsüberwachung einfügen, beschreiben wir unter Zustandsüberwachung.
Wie wir dabei unterstützen
Wir klären zuerst, ob die Aufgabe ein Modell braucht — und sagen es, wenn nicht. Wo es eines braucht, entwerfen wir die Datenerfassung so, dass die nötige Streuung entsteht, bauen Vorverarbeitung und Modell gemeinsam auf das Speicher- und Zeitbudget der Zielhardware hin, messen auf dem Gerät statt zu schätzen und legen die Prüfungen fest, die vor der Auslieferung stattfinden müssen.
Ebenso sehen wir den Weg für spätere Modellaktualisierungen und die Rückmeldung aus dem Feld von Anfang an vor, weil beides nachträglich kaum nachzurüsten ist.
Weiterführend: Sensorauswahl und Signalaufbereitung, Zustandsüberwachung, Cloud-Backend und Auswertungen und Vorausschauende Wartung. Die englischsprachige Fassung finden Sie unter Edge AI on microcontrollers.
Häufige Fragen
Was Auftraggeber vorab fragen
Kann auf einem Mikrocontroller wirklich ein neuronales Netz laufen?
Ja, und zwar seit Jahren zuverlässig — allerdings nicht die Modelle, die man aus der Bilderkennung im Netz kennt. Auf einem Mikrocontroller mit einigen hundert Kilobyte Speicher laufen Modelle mit einigen zehntausend bis wenigen hunderttausend Parametern. Das genügt für klar umrissene Aufgaben: einen Maschinenzustand aus einem Schwingungssignal erkennen, ein Schlüsselwort in Sprache finden, eine einfache Geste unterscheiden, eine Abweichung vom gewohnten Verhalten melden. Es genügt nicht für allgemeine Bilderkennung oder Sprachverstehen.
Wie viel Speicher braucht ein Modell?
Zwei Angaben sind zu unterscheiden. Die Modellparameter liegen im Programmspeicher und sind bei ganzzahliger Darstellung etwa ein Byte je Parameter — ein Modell mit fünfzigtausend Parametern belegt also rund fünfzig Kilobyte. Hinzu kommt der Arbeitsspeicher für die Zwischenergebnisse während der Auswertung, und der wird regelmäßig unterschätzt: Er richtet sich nach der größten Zwischenschicht und kann ein Vielfaches der Parametergröße betragen. Dazu kommen der Zwischenspeicher für das Eingangssignal und der Bedarf der Vorverarbeitung, die häufig mehr Speicher braucht als das Modell.
Was kostet die Quantisierung an Genauigkeit?
Bei den meisten Aufgaben dieser Art überraschend wenig — üblich sind Einbußen im Bereich von einem Prozentpunkt oder darunter, wenn die Umstellung sorgfältig gemacht wird. Der Gewinn ist dagegen erheblich: ein Viertel des Speichers und ein deutlich schnellerer Ablauf, weil Mikrocontroller Ganzzahlen weit besser verarbeiten als Gleitkommazahlen. Entscheidend ist, die Genauigkeit nach der Umstellung auf dem Gerät zu messen und nicht auf dem Entwicklungsrechner — und einzelne Schichten in höherer Genauigkeit zu belassen, wo es nötig ist.
Brauchen wir einen besonderen KI-Baustein?
Meist nicht. Für die Aufgaben, um die es hier geht, genügt ein gewöhnlicher Mikrocontroller mit ausreichend Speicher und einer Recheneinheit für Signalverarbeitung. Besondere Beschleuniger lohnen sich, wo Bilder in nennenswerter Auflösung verarbeitet werden oder wo die Auswertung sehr häufig stattfinden muss. Sie bringen allerdings eigene Werkzeugketten mit, binden an einen Hersteller und sind bei Lieferengpässen schwerer zu ersetzen. Unser Rat ist, zuerst auf gewöhnlicher Technik zu messen, ob es reicht.
Wie viele Trainingsdaten brauchen wir?
Weniger, als man befürchtet, und aus mehr Situationen, als man erwartet. Für eine klar umrissene Unterscheidung genügen häufig einige hundert Beispiele je Klasse — vorausgesetzt, sie decken die Streuung ab, die im Einsatz tatsächlich auftritt: verschiedene Exemplare, verschiedene Einbaulagen, verschiedene Temperaturen, verschiedene Betriebszustände. Tausend Beispiele von einem einzigen Gerät sind für ein Modell weniger wert als zweihundert von zehn verschiedenen Geräten. Die Streuung ist die Aufgabe, nicht die Menge.
Lässt sich das Modell nach der Auslieferung aktualisieren?
Ja, wenn es von Anfang an vorgesehen wurde. Das Modell sollte als eigener Bereich im Speicher liegen und getrennt von der übrigen Gerätesoftware austauschbar sein. Dazu gehören eine Prüfsumme, eine Versionsnummer, ein Weg zurück auf den vorigen Stand und die Möglichkeit, die Aktualisierung stufenweise auszurollen. Wichtig ist außerdem, mit jedem Ergebnis die Modellversion mitzuführen — sonst lässt sich später nicht feststellen, welche Aussage von welchem Stand stammt.
Sollte die Auswertung im Gerät oder in der Cloud laufen?
Im Gerät, wenn das Rohsignal zu groß zum Übertragen ist, wenn die Antwort schnell kommen muss, wenn die Verbindung unzuverlässig ist oder wenn die Rohdaten den Standort nicht verlassen sollen. Außerhalb, wenn die Auswertung viel Rechenleistung braucht, wenn sie häufig geändert werden soll oder wenn Daten mehrerer Anlagen zusammen betrachtet werden. Eine verbreitete und sinnvolle Aufteilung ist beides: Im Gerät wird entschieden, ob etwas interessant ist, und nur dann wird das Rohsignal zur genaueren Betrachtung hochgeladen.
Wann ist das der falsche Ansatz?
Wenn eine einfache Regel dasselbe leistet — und das ist häufiger der Fall, als angenommen wird. Eine Grenzwertüberwachung, ein Schwellwert auf einem Frequenzband, ein Vergleich mit dem Vortag: Solche Verfahren sind nachvollziehbar, brauchen keine Trainingsdaten und lassen sich vor Ort erklären. Ebenfalls falsch ist der Ansatz, wenn keine Beispieldaten vorliegen und auch keine beschafft werden können, oder wenn das zu erkennende Ereignis so selten ist, dass es in den verfügbaren Daten nicht vorkommt.
Was soll das Gerät erkennen?
Beschreiben Sie kurz, welche Unterscheidung getroffen werden soll und welche Daten dazu bereits vorliegen. Häufig lässt sich in einem Gespräch klären, ob ein Modell nötig ist oder eine Regel genügt.