Embedded-Firmware, die im Feld besteht
Firmware-Praxis für Geräte, die jahrelang ohne Eingriff laufen sollen: Schleife oder Betriebssystem, Unterbrechungen, Zeitbehandlung, Speicher ohne Überraschungen, Prüfbarkeit durch eine saubere Grenze und die Fähigkeit, über sich selbst zu berichten.
Kurz gefasst
- Die Abstraktionsgrenze entscheidet, wie viel sich prüfen lässt — und die meisten Fehler sitzen oberhalb davon.
- Kein dynamischer Speicher. Alles beim Start zuteilen, dann kann nichts später ausgehen.
- Der Wachhund gehört nicht in eine Unterbrechung. Sonst bestätigt er nur den Zeitgeber.
- Ein Gerät muss über sich selbst berichten können, sonst ist ein Feldfehler nicht zu finden.
- Der Bau muss reproduzierbar sein. Ohne das lässt sich ein ausgelieferter Stand nicht untersuchen.
Was das von anderer Software unterscheidet
Firmware auf einem Mikrocontroller unterliegt Bedingungen, die in der übrigen Softwareentwicklung nicht vorkommen — und die meisten Gewohnheiten von dort tragen hier nicht.
- Es gibt kein Neustarten. Ein Gerät, das jahrelang ohne Eingriff läuft, verzeiht keine Ressourcenlecks. Was langsam wächst, läuft irgendwann über.
- Der Speicher ist knapp und fest. Wenige zehn Kilobyte Arbeitsspeicher, und keine Möglichkeit, mehr zu bekommen.
- Es gibt selten jemanden, der zusieht. Ein Fehler äußert sich als Gerät, das nichts mehr meldet, nicht als Fehlermeldung auf einem Bildschirm.
- Die Fehlersuche ist mühsam. Ein Gerät im Feld lässt sich nicht anhalten und ansehen; es kann nur berichten, was es vorher aufgezeichnet hat.
- Änderungen sind teuer. Eine Korrektur muss über die Luft ausgerollt oder besucht werden.
- Zeit ist eine Zusage. Manche Vorgänge müssen innerhalb einer Frist erledigt sein, nicht im Mittel schnell.
Daraus folgt eine Haltung, die sich von der üblichen unterscheidet: Vorhersagbarkeit ist wichtiger als Bequemlichkeit. Ein Verfahren, das im Mittel schneller ist und gelegentlich lange braucht, ist hier schlechter als eines, das immer gleich lange braucht. Ein Speicherverfahren, das flexibel ist und scheitern kann, ist schlechter als eines, das unflexibel ist und nie scheitert.
Die Grundentscheidung: Schleife oder Betriebssystem
Am Anfang steht eine Entscheidung, die den gesamten Aufbau prägt und die häufig aus Gewohnheit statt aus Überlegung getroffen wird.
Eine Hauptschleife arbeitet der Reihe nach ab, was zu tun ist, und beginnt von vorn. Unterbrechungen setzen Kennzeichen, die die Schleife später auswertet. Der Ablauf ist vollständig durchschaubar, es gibt keine Nebenläufigkeit, und der Speicherbedarf ist bekannt. Der Preis: Jeder Schritt muss kurz sein, denn ein langer blockiert alles andere, und man muss den ungünstigsten Durchlauf kennen.
Ein Echtzeitbetriebssystem erlaubt mehrere Abläufe mit Prioritäten, sodass ein wichtiger einen weniger wichtigen unterbrechen kann. Das ist bequem, und es bringt eine ganze Klasse von Schwierigkeiten mit: gemeinsame Daten, die geschützt werden müssen; Fehler, die nur bei bestimmten zeitlichen Zufällen auftreten; ein eigener Stapelspeicher je Ablauf; und Verklemmungen.
Unsere Erfahrung: Eine Hauptschleife trägt weiter, als die meisten erwarten — bei Geräten, die messen, entscheiden und melden, meist vollständig. Ein Betriebssystem lohnt sich, wenn ein Netzwerkstapel eines voraussetzt, wenn Bibliotheken eingebunden werden müssen, die blockieren, oder wenn tatsächlich Abläufe mit sehr verschiedenen Zeitanforderungen nebeneinanderlaufen.
Wo es eingesetzt wird, gilt eine Regel, die viele Schwierigkeiten vermeidet: möglichst wenige Abläufe, möglichst wenige gemeinsame Daten. Vier Abläufe, die über Warteschlangen miteinander sprechen, sind beherrschbar; zwölf, die sich gegenseitig in gemeinsame Daten greifen, sind es nicht.
Die Logik in beiden Fällen gliedern
Unabhängig von dieser Entscheidung gilt für die Anwendungslogik dasselbe: Sie gehört als Zustandsautomat gebaut, nicht als Folge von Wartezeiten.
Der Unterschied zeigt sich an einem Beispiel. „Sensor einschalten, 200 ms warten, messen, ausschalten“ ist als Folge von Wartezeiten einfach zu schreiben und blockiert währenddessen alles. Als Zustandsautomat — „Zustand: Sensor eingeschaltet, seit 200 ms? dann messen und weiter“ — ist es etwas umständlicher zu schreiben und blockiert nicht.
Der zweite Vorteil ist der wichtigere: Ein Zustandsautomat lässt sich prüfen, ohne dass Zeit vergeht. Man setzt ihn in einen Zustand, reicht ein Ereignis hinein und prüft, was herauskommt — auf einem gewöhnlichen Rechner, in Millisekunden, tausendfach. Eine Logik aus Wartezeiten lässt sich nur in Echtzeit prüfen, und das heißt in der Praxis: gar nicht.
Unterbrechungen und die Fehler, zu denen sie verleiten
Unterbrechungen sind das Mittel, mit dem ein Mikrocontroller auf Ereignisse reagiert, und sie sind die Quelle der schwersten Fehlerarten — weil sie an jeder Stelle eintreten können und sich damit einer Betrachtung des Ablaufs entziehen.
Die Regeln, die sich bewährt haben:
- So kurz wie möglich. Ein Kennzeichen setzen, einen Wert in einen Puffer legen, mehr nicht. Alles Weitere gehört in die Schleife.
- Nichts aufrufen, was blockieren kann. Keine Wartezeiten, keine Ausgaben, keine Speicheranforderung.
- Gemeinsame Daten schützen. Ein Wert, den eine Unterbrechung ändert und die Schleife liest, muss so gekennzeichnet sein, dass der Übersetzer ihn nicht wegoptimiert — und wenn er größer ist als ein Maschinenwort, muss der Zugriff geschützt werden.
- Prioritäten bewusst vergeben, nicht alle gleich lassen.
- Den Stapelbedarf mitrechnen. Unterbrechungen nutzen denselben Stapel und können sich verschachteln.
Der dritte Punkt ist die häufigste Ursache von Fehlern, die sich nicht nachstellen lassen. Ein Zähler, den eine Unterbrechung erhöht und die Schleife liest, wird auf einem 8- oder 16-Bit-Baustein in mehreren Schritten gelesen — und wenn die Unterbrechung dazwischenkommt, entsteht ein Wert, den es nie gab. Solche Fehler treten alle paar Tage auf, nie im Versuch, und sie kosten mehr Zeit als alles andere.
Zeit, die schwieriger ist, als sie aussieht
Zeitbehandlung wirkt trivial und ist eine wiederkehrende Fehlerquelle. Vier Punkte machen den Unterschied.
- Der Überlauf des Zeitzählers. Ein Zähler, der Millisekunden zählt, läuft irgendwann über. Vergleiche der Form „ist die Zeit schon erreicht?“ verhalten sich dann falsch — richtig ist, die Differenz zu bilden und diese zu vergleichen, weil die Differenz auch über den Überlauf hinweg stimmt.
- Die Genauigkeit des Zeitgebers. Ein einfacher interner Zeitgeber weicht um Prozente ab und wandert mit der Temperatur. Wo es auf die Zeit ankommt, braucht es einen Schwingquarz — und wo eine Uhrzeit gebraucht wird, einen gelegentlichen Abgleich von außen.
- Zeitmessung über den Ruhezustand hinweg. Ein Gerät, das schläft, hält seinen üblichen Zeitzähler an. Für die verstrichene Zeit braucht es einen Zeitgeber, der weiterläuft.
- Das Verhalten bei Zeitsprüngen. Wird die Uhr von außen gestellt, darf das keine Berechnung durcheinanderbringen — weshalb für Zeitabstände eine monoton laufende Zeit verwendet wird und nicht die Uhrzeit.
Der letzte Punkt ist derjenige, der die unangenehmsten Fehler erzeugt. Ein Gerät, dessen Uhr beim Verbindungsaufbau gestellt wird und das seine Wartezeiten gegen die Uhrzeit rechnet, kann nach dem Stellen der Uhr eine Wartezeit haben, die in der Vergangenheit endet — oder eine, die Stunden dauert. Zwei getrennte Zeitquellen zu führen, eine monotone für Abstände und eine gestellte für Zeitstempel, löst das vollständig.
Einstellungen und dauerhafter Zustand
Fast jedes Gerät muss sich etwas merken, das einen Neustart übersteht: Einstellungen, Kalibrierwerte, Betriebsstunden, Zählerstände. Das klingt einfach und ist eine wiederkehrende Fehlerquelle, weil der Speicher, in dem das liegt, sich anders verhält als Arbeitsspeicher.
- Ein Schreibvorgang kann unterbrochen werden. Fällt der Strom mitten im Schreiben aus, ist der Inhalt weder alt noch neu. Deshalb wird abwechselnd in zwei Bereiche geschrieben, mit einem Zähler und einer Prüfsumme — und beim Start wird der jüngere gültige genommen.
- Der Speicher nutzt sich ab. Er verträgt eine begrenzte Zahl von Schreibvorgängen je Stelle. Ein Zählerstand, der jede Sekunde geschrieben wird, erschöpft ihn innerhalb von Monaten. Abhilfe: seltener schreiben, über den Bereich verteilt schreiben, oder nur bei Änderung.
- Es wird blockweise gelöscht. Eine einzelne Stelle zu ändern bedeutet häufig, einen ganzen Block zu löschen und neu zu schreiben — was Zeit kostet und währenddessen unterbrechbar ist.
- Der Inhalt braucht eine Fassungsnummer. Eine neue Firmware, die auf Einstellungen einer älteren Struktur trifft, muss das erkennen und umsetzen können.
- Es braucht einen Rückfall. Sind die Einstellungen unlesbar, muss das Gerät mit sinnvollen Voreinstellungen starten statt gar nicht.
Der vierte Punkt wird beim ersten Stand nie gebraucht und beim dritten dringend. Eine Fassungsnummer von Anfang an mitzuführen kostet zwei Byte und erspart die Wahl zwischen einer Aktualisierung, die alle Einstellungen verwirft, und einer, die auf falsch gedeutete Daten trifft.
Für Betriebsstundenzähler und ähnliche stetig wachsende Werte hat sich ein einfaches Verfahren bewährt: im Arbeitsspeicher mitzählen und nur gelegentlich schreiben — etwa stündlich und zusätzlich bei erkanntem Spannungseinbruch. Der Verlust von bis zu einer Stunde ist in aller Regel hinnehmbar, die Abnutzung des Speichers dagegen nicht.
Speicher: bekannt statt erhofft
Auf einem Mikrocontroller ist der Speicher eine feste Größe, und die Aufgabe besteht darin, den Bedarf zu kennen statt zu hoffen.
Keine dynamische Belegung. Die verbreitete Regel, und sie hat einen guten Grund: Über Wochen zerstückelt sich der Speicher, sodass eine Anforderung scheitern kann, obwohl rechnerisch genug frei wäre. Dieser Fall tritt nach Wochen auf, nie im Versuch, und er ist kaum nachzustellen. Wird aller Speicher beim Start fest zugeteilt, ist der Bedarf bekannt — und was beim Start passt, passt für immer.
Den Stapelspeicher messen. Der zweite große Posten, und er lässt sich nicht berechnen, sondern nur messen: Der Bereich wird beim Start mit einem Muster gefüllt, und später zeigt sich, bis wohin es überschrieben wurde. Gemessen wird unter ungünstigen Bedingungen — tiefe Verschachtelung, verschachtelte Unterbrechungen, Fehlerbehandlung.
Einen Überlauf erkennbar machen. Ein überlaufener Stapel überschreibt andere Daten und äußert sich als scheinbar zufälliger Fehler an ganz anderer Stelle — die zeitraubendste Art von Fehler überhaupt. Wo der Baustein eine Schutzfunktion bietet, gehört sie eingeschaltet; sonst hilft ein Muster am Ende des Bereichs, das regelmäßig geprüft wird.
Den Verbrauch bei jedem Bau ausweisen. Eine Zeile in der Übersetzungsausgabe, die Programm- und Arbeitsspeicherbedarf nennt, macht ein schleichendes Wachstum sichtbar. Wer sie beobachtet, merkt rechtzeitig, dass es eng wird.
Ein Wort zu Sprache und Werkzeugen
Die Sprachfrage wird in diesem Bereich mit mehr Leidenschaft geführt, als ihr zusteht. Nüchtern betrachtet:
C ist nach wie vor der Regelfall, unterstützt von jedem Baustein, mit Bibliotheken für alles und einem großen Vorrat an Fachleuten. Seine Schwächen sind bekannt — es verhindert wenig —, und ein erheblicher Teil davon lässt sich durch Prüfwerkzeuge und einen Satz von Regeln auffangen.
C++ bringt Möglichkeiten mit, die in eingebetteten Systemen nützlich sind, und andere, die dort nicht hingehören. Es lohnt sich mit einer klaren Festlegung, welche Sprachmittel verwendet werden — insbesondere ohne dynamische Speicherbelegung und ohne Ausnahmen.
Rust löst eine ganze Klasse von Speicherfehlern bereits beim Übersetzen und ist für eingebettete Systeme brauchbar geworden. Zu bedenken sind die Verfügbarkeit von Fachleuten über die Produktlebensdauer und die Unterstützung für den gewählten Baustein.
Wichtiger als die Sprache sind drei Dinge, die in jeder gelten: Prüfwerkzeuge einschalten und ihre Meldungen ernst nehmen, denn ein Übersetzer mit strengen Einstellungen findet einen erheblichen Teil der Fehler umsonst; einen Satz von Regeln festlegen, an den sich alle halten; und die Werkzeugversionen festschreiben, damit derselbe Quelltext in zwei Jahren dasselbe Ergebnis liefert.
Die Grenze ziehen
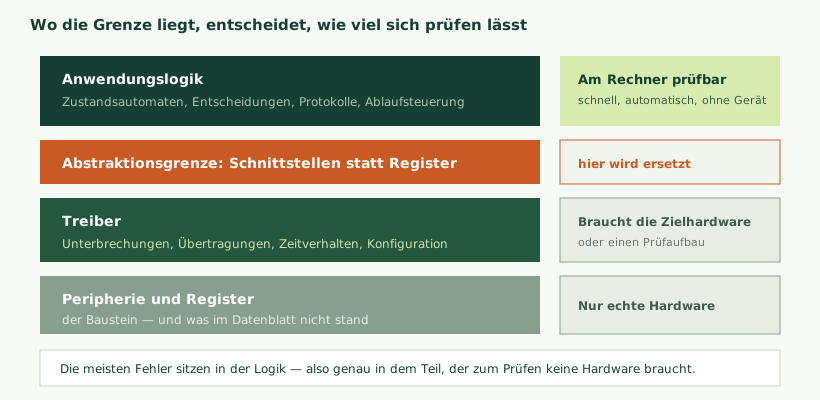
Die folgenreichste Entwurfsentscheidung in der Firmware ist, wo die Grenze zwischen Anwendungslogik und Hardware verläuft — weil sie bestimmt, wie viel sich prüfen lässt und wie schwer ein Wechsel des Bausteins wird.
Oberhalb der Grenze steht die Logik: Zustandsautomaten, Entscheidungen, Protokollbehandlung, Ablaufsteuerung. Sie spricht nicht mit Registern, sondern mit Schnittstellen — „gib mir den Messwert“, „sende diese Daten“, „wie spät ist es?“. Unterhalb stehen die Treiber, die diese Schnittstellen auf den konkreten Baustein abbilden.
Der Gewinn ist zweifach. Erstens lässt sich die Logik auf einem gewöhnlichen Rechner prüfen, indem die Schnittstellen durch Ersatzumsetzungen bedient werden — schnell, automatisch, in großer Zahl und ohne Hardware. Zweitens beschränkt ein Wechsel des Mikrocontrollers die Änderungen auf die Treiber, was aus einer Neuentwicklung eine überschaubare Arbeit macht.
Der Aufwand dafür ist geringer, als er klingt: Es geht nicht um eine allgemeine Abstraktionsschicht, sondern um genau die Schnittstellen, die diese Anwendung braucht. Sechs bis zehn Funktionen genügen häufig.
Wo die Grenze fehlt — wo die Logik unmittelbar Register beschreibt —, ist der gesamte Code nur auf der Zielhardware prüfbar, und das heißt in der Praxis: Er wird von Hand geprüft, einmal, und danach nicht mehr.
Sicher scheitern
Ein Gerät im Feld wird in Zustände geraten, die niemand vorhergesehen hat. Was es dann tut, gehört entworfen und nicht dem Zufall überlassen.
- Ein Wachhund, der etwas Sinnvolles überwacht. Nicht aus einer Unterbrechung bedienen — dann bestätigt er nur den Zeitgeber. Brauchbar ist: Jeder Ablauf setzt ein Lebenszeichen, und der Wachhund wird an einer Stelle nur bedient, wenn alle vorliegen.
- Den Grund des letzten Neustarts festhalten. Wachhund, Unterspannung, Ausnahmefehler, planmäßiger Neustart — diese Angabe ist bei der Fehlersuche im Feld die erste, nach der man greift.
- Ausnahmefehler behandeln. Ein Zugriff auf eine ungültige Adresse löst eine Ausnahme aus; die Vorgabe ist meist eine Endlosschleife. Besser: Zustand festhalten, dann neu starten.
- Einen definierten sicheren Zustand. Was tun Ausgänge bei einem Neustart? Ein Ventil, das dabei öffnet, ist möglicherweise kein Detail.
- Eingaben prüfen. Alles, was von außen kommt — über Funk, über eine Schnittstelle, aus dem Speicher —, ist möglicherweise fehlerhaft.
- Nach einem Neustart weiterarbeiten. Das Gerät muss seinen Zustand wiederfinden, ohne dass jemand eingreift.
Der zweite Punkt kostet wenige Zeilen und beantwortet später Fragen, die sonst unbeantwortbar sind. Ein Gerät, das meldet „Neustart wegen Wachhund, zum dritten Mal in dieser Woche“, führt die Fehlersuche unmittelbar an die richtige Stelle. Eines, das nur neu startet, führt sie nirgendwohin.
Fehlerbilder und wo man zuerst sucht
Bestimmte Fehlerbilder wiederholen sich in eingebetteten Systemen so beständig, dass sich eine erste Vermutung fast immer angeben lässt. Die folgende Zuordnung erspart einen erheblichen Teil der Suchzeit.
| Was man beobachtet | Erste Vermutung | Wie man es prüft |
|---|---|---|
| Gerät startet nach Tagen oder Wochen neu | Wachhund, ausgelöst durch einen hängenden Ablauf | Grund des Neustarts festhalten und auswerten |
| Fehler tritt scheinbar zufällig auf | Stapelüberlauf oder ungeschützte gemeinsame Daten | Stapelbedarf messen; Zugriffe auf gemeinsame Werte prüfen |
| Fehler tritt nur unter Last auf | Zeitverhalten: ein Durchlauf dauert länger als angenommen | Laufzeit an einem Anschluss ausgeben und messen |
| Wert springt gelegentlich auf Unsinn | Mehrteiliger Zugriff, unterbrochen durch eine Unterbrechung | Zugriff schützen und beobachten, ob es aufhört |
| Kommunikation bricht sporadisch ab | Falscher Takt oder Puffer ohne Überlaufbehandlung | Takt messen; Empfangspfad mit beschädigten Daten prüfen |
| Einstellungen gehen verloren | Schreibvorgang durch Spannungsausfall unterbrochen | Abwechselnd in zwei Bereiche schreiben, mit Prüfsumme |
| Gerät verhält sich nach Monaten anders | Abnutzung des dauerhaften Speichers oder Überlauf eines Zählers | Schreibhäufigkeit prüfen; Zählerbreite und Überlaufbehandlung prüfen |
| Fehler nur bei Kälte oder Wärme | Takt aus einer internen Quelle, die mit der Temperatur wandert | Über Temperatur messen; auf Quarz umstellen |
Auffällig an dieser Aufstellung ist, wie wenige verschiedene Ursachen die meisten Erscheinungsbilder erklären. Vier Familien decken den überwiegenden Teil ab: ungeschützte gemeinsame Daten, Stapelüberlauf, Zeitverhalten und Fehler im Umgang mit dem dauerhaften Speicher.
Das ist eine nützliche Erkenntnis, weil sie die Reihenfolge der Untersuchung bestimmt. Bevor ein Fehler in der Anwendungslogik gesucht wird, lohnt sich ein Durchgang durch diese vier — er dauert einen Tag und löst einen erheblichen Teil der Fälle.
Die letzte Zeile verdient einen eigenen Hinweis, weil sie besonders schwer zuzuordnen ist: Ein Gerät, das nur im Winter oder nur in einer warmen Halle auffällig wird, hat fast nie ein Logikproblem. Die Ursachen sind dann der Takt, die Batteriespannung unter Last oder ein analoger Wert, der mit der Temperatur wandert — und keine davon ist im Code zu finden.
Finden, was sich nicht nachstellen lässt
Der unangenehmste Fall der eingebetteten Entwicklung: Ein Gerät im Feld verhält sich auffällig, und auf dem Schreibtisch lässt es sich nicht nachstellen. Ob dieser Fall lösbar ist, entscheidet sich vor der Auslieferung.
Was ein Gerät dafür können muss:
- Ein Ringspeicher im dauerhaften Speicher mit den letzten Ereignissen — Neustarts mit Grund, Verbindungsabbrüche, Fehlerzustände, außergewöhnliche Messwerte. Klein, mit fester Größe, sparsam beschrieben.
- Zähler für alles, was nicht passieren sollte: Wachhundneustarts, gescheiterte Sendeversuche, Prüfsummenfehler, verworfene Nachrichten.
- Der Zustand beim Fehler: freier Stapel, Zeit seit dem Start, letzter bearbeiteter Zustand.
- Ein Weg, das abzurufen — mit einer Meldung mitgeschickt oder über eine Schnittstelle abfragbar.
- Eine Betriebsart mit ausführlicherer Aufzeichnung, die sich für ein einzelnes auffälliges Gerät einschalten lässt.
Der letzte Punkt ist besonders nützlich und wird selten eingebaut. Ein Gerät, das sich aus der Ferne in einen gesprächigeren Zustand versetzen lässt, verwandelt einen Fall, der eine Anfahrt erfordert hätte, in eine Beobachtung über zwei Tage.
Diese Fähigkeiten kosten wenig Speicher und lassen sich nachträglich nicht einbauen — jedenfalls nicht für das Gerät, das gerade auffällig ist. Wer sie hat, löst solche Fälle in Tagen; wer sie nicht hat, tauscht Geräte und hofft.
Ein Wort zur Fehlersuche mit Ausgaben
Meldungen über eine serielle Schnittstelle sind das naheliegendste Hilfsmittel und zugleich eines, das den Fehler verändern kann. Eine Ausgabe braucht Zeit — bei niedriger Übertragungsrate erhebliche —, und eine Ausgabe aus einer Unterbrechung heraus verschiebt das Zeitverhalten so stark, dass ein zeitabhängiger Fehler verschwindet, solange man ihn beobachtet.
Brauchbarer sind zwei Alternativen. Erstens ein Anschluss, der am Anfang eines Abschnitts gesetzt und am Ende gelöscht wird: Mit einem Oszilloskop lässt sich damit die Laufzeit messen, ohne den Ablauf zu stören. Zweitens ein Ringspeicher im Arbeitsspeicher, in den nur eine Nummer und ein Zeitstempel geschrieben werden — das kostet Nanosekunden und lässt sich später in Ruhe auslesen.
Kommunikationscode, wo sich die Fehler sammeln
Wenn man nachträglich zählt, wo die Fehler in einem Firmwareprojekt saßen, liegt ein auffälliger Anteil im Code, der mit der Außenwelt spricht — mit einem Sensor, einem Funkmodul, einer Steuerung, einem Bediengerät.
Der Grund ist, dass dieser Code mit etwas umgehen muss, das sich nicht an Absprachen hält. Die wiederkehrenden Fehler:
- Längenangaben aus der Nachricht ungeprüft verwenden. Eine Nachricht, die behauptet, zweihundert Byte lang zu sein, während der Puffer sechzig fasst, überschreibt alles dahinter. Die Länge gehört geprüft, bevor sie verwendet wird — jedes Mal.
- Annehmen, dass eine Nachricht vollständig ankommt. Über eine serielle Schnittstelle kommt sie stückweise, und ein Zustandsautomat für den Empfang ist nicht optional.
- Keine Zeitüberschreitung vorsehen. Eine Gegenstelle, die mitten in einer Nachricht verstummt, darf den Empfänger nicht dauerhaft in einem Zwischenzustand lassen.
- Puffer ohne Überlaufbehandlung. Was geschieht, wenn mehr ankommt, als hineinpasst? Verwerfen ist eine Antwort, Überschreiben ist keine.
- Prüfsummen berechnen und nicht auswerten. Kommt vor, und zwar häufiger, als man glaubt.
- Byte-Reihenfolge annehmen statt festlegen. Zwei Geräte verschiedener Bauart deuten dieselben Daten unterschiedlich.
Die brauchbarste Gegenmaßnahme ist, diesen Code als Zustandsautomaten oberhalb der Abstraktionsgrenze zu bauen — dann lässt er sich am Rechner mit beliebigen Eingaben prüfen, einschließlich absichtlich beschädigter. Ein Prüflauf, der zufällig veränderte Nachrichten hineingibt und erwartet, dass nichts abstürzt, findet in einer Stunde Fehler, die sonst Monate im Feld überdauern.
Prüfen
Firmware zu prüfen gilt als schwierig, weil Hardware im Spiel ist. Tatsächlich ist der größte Teil ohne Hardware prüfbar, sofern die Grenze richtig gezogen wurde.
| Ebene | Wo | Womit |
|---|---|---|
| Anwendungslogik | Entwicklungsrechner | Einzelprüfungen mit Ersatzumsetzungen der Schnittstellen |
| Protokollbehandlung | Entwicklungsrechner | Aufgezeichnete und absichtlich beschädigte Nachrichten |
| Treiber | Zielhardware | Kleiner Prüfaufbau mit einem Gerät |
| Zeitverhalten | Zielhardware | Messung mit einem Anschluss und einem Oszilloskop |
| Energiebilanz | Zielhardware | Strommessung über vollständige Zyklen |
| Zusammenspiel | Prüfaufbau | Gerät, angeschlossene Peripherie, gesteuerte Versorgung |
| Dauerlauf | Prüfaufbau | Tage bis Wochen, mit Aufzeichnung |
Der Prüfaufbau in den letzten Zeilen ist die Investition, die sich am meisten lohnt und am seltensten gemacht wird. Ein Gerät, eine schaltbare Versorgung, ein Rechner, der Abläufe anstößt und mitschreibt — damit lassen sich über Nacht tausend Stromunterbrechungen, hundert Verbindungsabbrüche und ein Dauerlauf über eine Woche durchführen. Das findet genau die Fehler, die sonst im Feld auftreten.
Ein Hinweis zur Reihenfolge: Es lohnt sich, mit den Einzelprüfungen der Logik anzufangen und nicht mit dem Prüfaufbau. Sie sind schneller gebaut, laufen in Sekunden und decken den Teil ab, in dem die meisten Fehler sitzen.
Firmware in der Fertigung
Ein Bereich, der beim Entwurf vergessen und bei der ersten Serie dringend wird: Wie kommt die Firmware in das Gerät, und was geschieht dabei?
- Das Aufspielen selbst, mit einer Prüfung, dass es funktioniert hat.
- Die Gerätekennung einbringen und aufzeichnen, welches Gerät welche trägt.
- Kalibrierwerte ermitteln und ablegen, wo das Gerät sie braucht.
- Eine Endprüfung, die die Baugruppe durchmisst — häufig mit einer eigenen Prüf-Firmware, die mehr kann als die eigentliche.
- Die Schutzfunktionen einschalten: Ausleseschutz, Abschalten der Programmierschnittstelle. Der Schritt, der am häufigsten vergessen wird.
- Eine Aufzeichnung, welches Gerät welchen Stand erhalten hat.
Die Prüf-Firmware verdient eine eigene Anmerkung. Sie ist ein eigenes Erzeugnis mit eigener Pflege, und sie ist der Weg, auf dem Bequemlichkeiten in die Serie gelangen — etwa ein Zugang, der die Signaturprüfung überspringt. Sie gehört deshalb so gebaut, dass sie am Ende der Fertigung sicher durch die richtige ersetzt wird, und die Endkontrolle sollte das prüfen.
Bauvorgänge, die sich wiederholen lassen
Eine unspektakuläre Eigenschaft mit großer Wirkung: Aus demselben Quelltext sollte in zwei Jahren dasselbe Abbild entstehen — bitgenau.
Warum das zählt: Ein Gerät im Feld verhält sich auffällig, und die Frage lautet, welcher Stand darauf läuft. Ohne reproduzierbaren Bau lässt sich das nicht sicher beantworten. Für eine Sicherheitsbehebung an einem drei Jahre alten Stand muss dieser Stand erst einmal wieder erzeugt werden können.
Was dafür nötig ist:
- Die Werkzeugversionen festschreiben — Übersetzer, Binder, Bibliotheken, bis auf die Unterversion.
- Eine gekapselte Bauumgebung, die sich mitliefern lässt, statt einer Beschreibung, was zu installieren ist.
- Alle Abhängigkeiten mit festen Ständen, nicht mit „neueste Fassung“.
- Zeitstempel und Pfade aus dem Abbild heraushalten, weil sie es sonst bei jedem Bau verändern.
- Den Bau automatisieren, damit er nicht von den Einstellungen eines bestimmten Rechners abhängt.
- Jeden ausgelieferten Stand archivieren, mit Abbild, Quelltextstand und Bestandsliste.
Die häufigste unangenehme Entdeckung bei einer Übernahme fremder Firmware ist genau hier: Der ausgelieferte Stand lässt sich aus dem vorhandenen Quelltext nicht mehr erzeugen, weil irgendwo eine Einstellung fehlt, die nur auf dem Rechner eines ausgeschiedenen Mitarbeiters vorhanden war.
Eine neue Leiterplatte in Betrieb nehmen
Die ersten Stunden mit einer neuen Baugruppe verlaufen geordneter, wenn man eine Reihenfolge einhält — und ungeordnet, wenn man sofort die Anwendung aufspielt.
- Versorgungsspannungen messen, bevor etwas eingeschaltet wird. Eine falsche Spannung zerstört Bauteile.
- Den Baustein erreichen. Lässt er sich über die Programmierschnittstelle ansprechen?
- Das kleinstmögliche Programm. Eine blinkende Leuchtdiode beweist, dass Takt, Versorgung und Programmierkette stimmen.
- Den Takt prüfen, an einem Anschluss ausgegeben und gemessen. Ein falsch eingestellter Takt verfälscht später alle Zeiten.
- Eine Ausgabemöglichkeit schaffen, über die sich Meldungen absetzen lassen.
- Peripherie einzeln in Betrieb nehmen, jede für sich, nicht alle zusammen.
- Erst danach die Anwendung.
Der vierte Schritt wird häufig übersprungen und verursacht dann Fehler, die überall gesucht werden: Ein Baustein, der auf einem internen Takt statt auf dem Quarz läuft, weil die Umschaltung nicht griff, arbeitet einwandfrei — nur mit falschen Zeiten, was sich als sporadische Kommunikationsfehler äußert.
Fremde Firmware übernehmen
Ein regelmäßiger Fall: Ein Produkt existiert, der ursprüngliche Entwickler ist nicht mehr verfügbar, und es soll weitergehen. Die Reihenfolge, die sich bewährt hat, ist bewusst zurückhaltend.
- Bauen können. Vor allem anderen: Lässt sich der ausgelieferte Stand reproduzieren? Häufig ist das der erste Stolperstein.
- Aufspielen und laufen lassen, um zu sehen, dass der nachgebaute Stand sich wie der ausgelieferte verhält.
- Abhängigkeiten aufnehmen: Welche Fremdbestandteile, welche Versionen, welche Lizenzen?
- Die kritischen Stellen lesen — Unterbrechungen, Zeitbehandlung, Kommunikation, dauerhafter Speicher. Nicht alles, sondern das, wo Fehler sitzen.
- Prüfungen ergänzen, bevor etwas geändert wird — sie sind die Absicherung für alles Weitere.
- Kleine Änderungen zuerst, um ein Gefühl für das Verhalten zu bekommen.
- Erst dann über Umbauten entscheiden.
Zur Versuchung, neu zu schreiben: Sie ist groß und selten berechtigt. Fremder Code sieht ungewohnt aus, und ein Teil dessen, was unnötig kompliziert wirkt, ist die Antwort auf ein Problem, das man noch nicht kennt. Eine Neuentwicklung bedeutet außerdem, alle im Feld gefundenen Fehler erneut zu finden. Wir schlagen sie vor, wenn der Bestand nachweislich nicht mehr trägt — und erst, nachdem wir ihn verstanden haben.
Code, den jemand anders pflegen muss
Firmware wird länger gepflegt als geschrieben, und in aller Regel von jemand anderem. Was das für den Code bedeutet, lässt sich in wenigen Punkten sagen — und keiner davon ist ein Kunstgriff.
- Aufschreiben, warum, nicht was. Dass eine Zeile ein Bit setzt, steht dort; dass sie es setzt, weil ein bestimmter Baustein sonst nach einigen Stunden aussetzt, steht nirgends.
- Umwege benennen. Jeder nichtoffensichtliche Umweg um eine Eigenheit der Hardware gehört mit einem Satz erklärt, sonst wird er beim nächsten Aufräumen entfernt.
- Feste Zahlen vermeiden. Eine 47 im Code ist in zwei Jahren ein Rätsel; eine benannte Größe ist es nicht.
- Eine Beschreibung des Aufbaus auf zwei Seiten: welche Teile gibt es, wer ruft wen, wo liegt die Grenze, was läuft in Unterbrechungen.
- Nachvollziehbare Änderungsgeschichte. Eine Änderung, deren Grund sich nicht mehr feststellen lässt, kann niemand beurteilen.
- Die Prüfungen mitliefern. Sie sind zugleich die genaueste Beschreibung dessen, was der Code tun soll.
Was eine Übergabe enthalten sollte
- Den Quelltext mit vollständiger Versionsgeschichte, nicht als Momentaufnahme.
- Eine Bauumgebung, in der sich der ausgelieferte Stand bitgenau nachbauen lässt.
- Die genauen Werkzeugversionen und alle Abhängigkeiten mit festen Ständen.
- Die Bestandsliste der Fremdbestandteile mit Lizenzen.
- Die Beschreibung des Aufbaus und der Schnittstellen.
- Die Prüfungen mit ihren Ergebnissen und eine Anleitung, wie man sie ausführt.
- Die Fertigungsabläufe samt Prüf-Firmware und Prüfprogrammen.
- Die Signaturschlüssel oder einen nachvollziehbaren Weg zu ihnen.
- Eine Liste dessen, was bewusst so gebaut wurde und warum — einschließlich der bekannten Einschränkungen.
Der letzte Punkt ist der wertvollste und fehlt am häufigsten. Eine Seite mit den fünf Dingen, die man wissen muss, bevor man an diesem Code arbeitet, erspart dem Nachfolger Wochen.
Firmwarearbeit schätzen, und warum sie überzieht
Firmwareprojekte überziehen regelmäßig, und die Gründe wiederholen sich so beständig, dass sie sich einplanen lassen.
- Die Hardware kommt später als geplant, und ohne sie lässt sich ein Teil der Arbeit nicht abschließen.
- Die erste Baugruppe hat Fehler. Ein Teil der Zeit geht dafür drauf, Hardwarefehler zu finden und zu umgehen.
- Bausteine verhalten sich anders als beschrieben. Die Errata-Liste ist eine eigene Lektüre, und manches steht auch dort nicht.
- Die Anforderungen wachsen, weil sich beim Ausprobieren zeigt, was fehlt.
- Die Inbetriebnahme dauert länger, weil sie mit Hardware, Mechanik und Fertigung zusammenhängt.
- Die Zulassungsprüfung findet Dinge, die eine Änderung an der Firmware erfordern.
- Das letzte Zehntel — Fehlerbehandlung, Randfälle, Dauerlauf — kostet so viel wie die ersten neun.
Die brauchbare Gegenmaßnahme ist weniger eine bessere Schätzung als eine andere Reihenfolge: früh auf der Zielhardware laufen, auch mit unfertiger Funktion; die riskanten Teile zuerst; und die Prüfmittel vor der Funktion bauen. Was den Zeitplan sprengt, sind selten die vorhergesehenen Aufgaben, sondern die Zeit für die Fehlersuche — und die verkürzt sich erheblich, wenn die Prüfmittel bereits stehen.
Einen Prozessor aus Sicht der Firmware wählen
Die Auswahl erfolgt meist nach Preis, Verfügbarkeit und Peripherie. Aus Sicht der Firmware kommen einige Fragen hinzu, die sich später auswirken und beim Vergleich selten auftauchen.
- Ausreichend Speicher mit Reserve. Firmware wächst über die Lebensdauer immer; achtzig Prozent Belegung bei der Markteinführung ist zu viel.
- Zwei Programmbereiche möglich? Ohne sie kein sicherer Aktualisierungsweg.
- Ein einmalig beschreibbarer Bereich für Schlüssel und Kennung.
- Eine Schutzeinheit für den Speicher, die einen Stapelüberlauf erkennbar macht.
- Die Güte der Herstellerbibliotheken. Sie unterscheidet sich erheblich und bestimmt einen großen Teil der Arbeit.
- Die Errata-Liste lesen, bevor man sich festlegt. Sie sagt mehr über die kommende Arbeit als das Datenblatt.
- Verfügbarkeit über die Produktlebensdauer, und ob es verwandte Bausteine gibt, auf die sich ausweichen lässt.
- Ob jemand im Haus ihn kennt. Eine vertraute Familie spart mehr Zeit, als ein günstigerer Baustein an Geld spart.
Der sechste Punkt wird am seltensten befolgt und ist der aufschlussreichste. Eine Errata-Liste mit dreißig Einträgen, von denen mehrere die Peripherie betreffen, die man verwenden wollte, ist eine Ansage über den kommenden Aufwand — und sie ist vor der Entscheidung frei einsehbar.
Firmware prüfen lassen
Gelegentlich lohnt sich ein Blick von außen — vor einer Serienfreigabe, bei einer Übernahme, nach einer Reihe unerklärter Feldausfälle oder wenn ein Kunde es verlangt. Was dabei tatsächlich betrachtet wird:
- Die kritischen Stellen: Unterbrechungen, gemeinsame Daten, Zeitbehandlung, Kommunikationscode.
- Der Speicherbedarf, insbesondere der Stapel unter ungünstigen Bedingungen.
- Das Verhalten im Fehlerfall: Wachhund, Ausnahmen, Neustart, sicherer Zustand.
- Der dauerhafte Speicher: Schreibvorgänge, Abnutzung, Verhalten bei Unterbrechung.
- Der Aktualisierungsweg und seine Prüfungen.
- Die Reproduzierbarkeit des Baus und die Bestandsliste.
- Was ohne Hardware prüfbar ist — und was davon tatsächlich geprüft wird.
Ergebnis ist üblicherweise eine nach Dringlichkeit geordnete Liste, keine Neuentwicklung. In den meisten Fällen sind es einige wenige Stellen, die den überwiegenden Teil des Risikos tragen.
Kleines Glossar
| Begriff | Was gemeint ist |
|---|---|
| Hauptschleife | Aufbau ohne Betriebssystem; die Arbeit wird der Reihe nach abgearbeitet |
| Unterbrechung | Ein Ereignis, das den laufenden Ablauf an beliebiger Stelle unterbricht |
| Wachhund | Überwachung, die das Gerät zurücksetzt, wenn es sich nicht meldet |
| Stapelspeicher | Speicher für Aufrufe und lokale Größen; sein Überlauf erzeugt scheinbar zufällige Fehler |
| Abstraktionsgrenze | Die Trennung zwischen Logik und Hardwarezugriff; entscheidet über die Prüfbarkeit |
| Zustandsautomat | Aufbau aus Zuständen und Übergängen statt aus Wartezeiten |
| Errata | Liste bekannter Abweichungen eines Bausteins von seinem Datenblatt |
| Reproduzierbarer Bau | Derselbe Quelltext ergibt bitgenau dasselbe Abbild |
| Ringspeicher | Aufzeichnung fester Größe, in der die ältesten Einträge überschrieben werden |
Was typischerweise schiefgeht
- Keine Abstraktionsgrenze. Dann ist nichts ohne Hardware prüfbar, und ein Bausteinwechsel ist eine Neuentwicklung.
- Dynamische Speicherbelegung. Scheitert nach Wochen und ist nicht nachzustellen.
- Den Stapelbedarf nicht messen. Ein Überlauf äußert sich an ganz anderer Stelle.
- Den Wachhund aus einer Unterbrechung bedienen. Er überwacht dann den Zeitgeber, nicht das Gerät.
- Gemeinsame Daten nicht schützen. Erzeugt Fehler, die alle paar Tage auftreten.
- Keine Selbstauskunft im Gerät. Ein Feldfehler ist dann nicht zu finden.
- Der Bau ist nicht reproduzierbar. Ein ausgelieferter Stand lässt sich nicht untersuchen.
- Die Schutzfunktionen in der Fertigung vergessen. Hebt die übrigen Maßnahmen auf.
Wenn Sie eines mitnehmen
Zwei Entscheidungen bestimmen, wie eine Firmware über zehn Jahre altert. Die erste ist, wo die Grenze zwischen Logik und Hardware verläuft — sie entscheidet, wie viel sich prüfen lässt und wie teuer ein Bausteinwechsel wird. Die zweite ist, ob das Gerät über sich selbst berichten kann — sie entscheidet, ob ein Feldfehler in Tagen oder gar nicht gefunden wird.
Beide kosten beim ersten Mal wenig und lassen sich später kaum nachrüsten. Alles Übrige — Speicher, Zeit, Unterbrechungen, Fehlerbehandlung — ist Handwerk, das sich lernen und nachbessern lässt. Wie die Firmware mit der Energiebilanz zusammenhängt, behandeln wir unter Batterielaufzeit in vernetzten Geräten; den Aktualisierungsweg unter Gerätesicherheit und Aktualisierung über die Luft.
Wie wir dabei unterstützen
Wir entwickeln Firmware für Industrie- und Produktgeräte, mit einer Grenze, die den größten Teil des Codes ohne Hardware prüfbar macht, mit einem bekannten Speicherbedarf statt eines erhofften, und mit der Fähigkeit des Geräts, über sich selbst zu berichten. Wir bauen den Prüfaufbau mit, weil er die Fehler findet, die sonst im Feld auftreten.
Bei bestehender Firmware übernehmen wir sie in der oben beschriebenen Reihenfolge — bauen können, verstehen, absichern, dann ändern — und schlagen eine Neuentwicklung erst vor, wenn wir begründen können, warum der Bestand nicht mehr trägt. Und wir übergeben so, dass jemand anders weiterarbeiten kann.
Weiterführend: Gerätesicherheit und Aktualisierung über die Luft, Batterielaufzeit in vernetzten Geräten, Sensorschnittstellen und EMV in der Entwicklung. Die englischsprachige Fassung finden Sie unter Embedded firmware that survives the field.
Häufige Fragen
Was Auftraggeber vorab fragen
Brauchen wir ein Echtzeitbetriebssystem?
Seltener, als angenommen wird. Eine Hauptschleife mit einem Zustandsautomaten trägt erstaunlich weit — und sie hat den Vorteil, dass es keine Nebenläufigkeit gibt und damit eine ganze Klasse schwer zu findender Fehler entfällt. Ein Betriebssystem lohnt sich, wo mehrere Abläufe mit sehr verschiedenen Zeitanforderungen nebeneinanderlaufen, wo ein Netzwerkstapel eines voraussetzt oder wo blockierende Bibliotheken eingebunden werden müssen. Es bringt allerdings mit: Nebenläufigkeit, Zugriffsschutz zwischen Abläufen, mehrere Stapelspeicher und Fehler, die nur unter bestimmten zeitlichen Zufällen auftreten.
Warum sollte man dynamische Speicherbelegung vermeiden?
Weil sie auf einem Gerät mit wenigen zehn Kilobyte Arbeitsspeicher, das jahrelang ohne Neustart laufen soll, eine schlecht beherrschbare Unsicherheit einführt. Über die Zeit zerstückelt sich der Speicher, sodass eine Anforderung scheitern kann, obwohl rechnerisch genug frei wäre — und dieser Fall tritt nach Wochen auf, nicht im Versuch. Hinzu kommt, dass der Zeitbedarf einer Anforderung nicht vorhersagbar ist. Die übliche Vorgehensweise ist, allen Speicher beim Start fest zuzuteilen; dann ist der Bedarf bekannt, und es kann nichts ausgehen, was nicht schon beim Start ausgegangen wäre.
Woher wissen wir, dass der Stapelspeicher ausreicht?
Nicht durch Überlegung, sondern durch Messung. Die verbreitete Vorgehensweise ist, den Stapelbereich beim Start mit einem festen Muster zu füllen und später nachzusehen, bis wohin es überschrieben wurde — das zeigt den höchsten tatsächlich erreichten Stand. Gemessen wird unter den ungünstigsten Bedingungen: mit tief verschachtelten Aufrufen, während einer Unterbrechung, bei der Fehlerbehandlung. Ergänzend hilft eine Schutzfunktion, die einen Überlauf erkennt, statt ihn stillschweigend zuzulassen — ein überlaufener Stapel äußert sich sonst als scheinbar zufälliger Fehler an ganz anderer Stelle.
Ist es falsch, den Wachhund aus einer Zeitgeberunterbrechung zurückzusetzen?
Ja, und es ist einer der häufigsten Fehler überhaupt. Ein Wachhund, der aus einer Unterbrechung heraus bedient wird, läuft weiter, auch wenn die Hauptschleife längst hängt — er bestätigt dann nur noch, dass der Zeitgeber funktioniert. Brauchbar ist stattdessen, dass jeder Ablauf, der laufen soll, ein Lebenszeichen setzt, und dass der Wachhund an einer einzigen Stelle nur dann bedient wird, wenn alle Lebenszeichen vorliegen. Dann meldet er tatsächlich, dass das Gerät als Ganzes arbeitet.
Lässt sich Firmware ohne Hardware prüfen?
Der größte Teil ja, und zwar genau der Teil, in dem die meisten Fehler sitzen. Voraussetzung ist eine Abstraktionsgrenze: Die Anwendungslogik spricht nicht mit Registern, sondern mit Schnittstellen, die sich beim Prüfen durch Ersatzumsetzungen austauschen lassen. Dann lassen sich Zustandsautomaten, Protokollbehandlung und Entscheidungslogik auf einem gewöhnlichen Rechner prüfen — schnell, automatisch und in großer Zahl. Was die Hardware braucht, sind die Treiber und das Zeitverhalten, und dafür lohnt sich ein kleiner Prüfaufbau mit einem Gerät.
Können Sie Firmware übernehmen, die jemand anders geschrieben hat?
Ja, das ist ein regelmäßiger Auftrag. Wir beginnen damit, den Bestand reproduzierbar zu bauen — überraschend häufig ist das der erste Stolperstein, weil der ausgelieferte Stand sich aus dem vorhandenen Quelltext nicht mehr erzeugen lässt. Danach folgen eine Bestandsaufnahme der Abhängigkeiten, ein Durchgang durch die kritischen Stellen und eine Einschätzung, was ohne größeren Umbau änderbar ist. Was wir nicht tun, ist eine Neuentwicklung vorzuschlagen, bevor wir verstanden haben, warum der vorhandene Code so aussieht, wie er aussieht.
Was sollten wir bei einer Übergabe erhalten?
Den Quelltext mit vollständiger Versionsgeschichte, eine Umgebung, in der sich der ausgelieferte Stand bitgenau nachbauen lässt, die genauen Werkzeugversionen, die Bestandsliste der Fremdbestandteile, die Beschreibung der Schnittstellen und Protokolle, die Prüfungen mit ihren Ergebnissen, die Fertigungsabläufe samt Prüfprogrammen, die Signaturschlüssel oder den Weg zu ihnen, und eine Beschreibung dessen, was bewusst so gebaut wurde und warum. Der letzte Punkt ist der wertvollste und fehlt am häufigsten.
Wie findet man einen Fehler, der nur im Feld auftritt?
Indem man das Gerät befähigt, über sich selbst zu berichten. Ein Ringspeicher im dauerhaften Speicher, der die letzten Ereignisse und den Grund des letzten Neustarts festhält, beantwortet einen erheblichen Teil dieser Fälle — vorausgesetzt, er wurde vor der Auslieferung eingebaut. Dazu gehören Zähler für auffällige Ereignisse, die Aufzeichnung des Zustands beim Auftreten eines Fehlers und die Möglichkeit, diese Angaben mit einer Meldung mitzuschicken. Wer das nachträglich braucht, hat es nicht.
Woran arbeiten Sie gerade?
Beschreiben Sie kurz, um welches Gerät es geht und in welchem Zustand die Firmware ist. Auch die Übernahme eines bestehenden Bestands und die Suche nach einem Fehler, der nur im Feld auftritt, sind regelmäßige Aufträge.